
Zusammenfassung für Eilige:
Seit dem 2. August 2026 gilt in der EU eine Kennzeichnungspflicht für KI-generierte Inhalte (Artikel 50 AI Act). Anthropic hat Mitte August erklärt, wie Claude das umsetzt – weltweit, nicht nur in Europa.
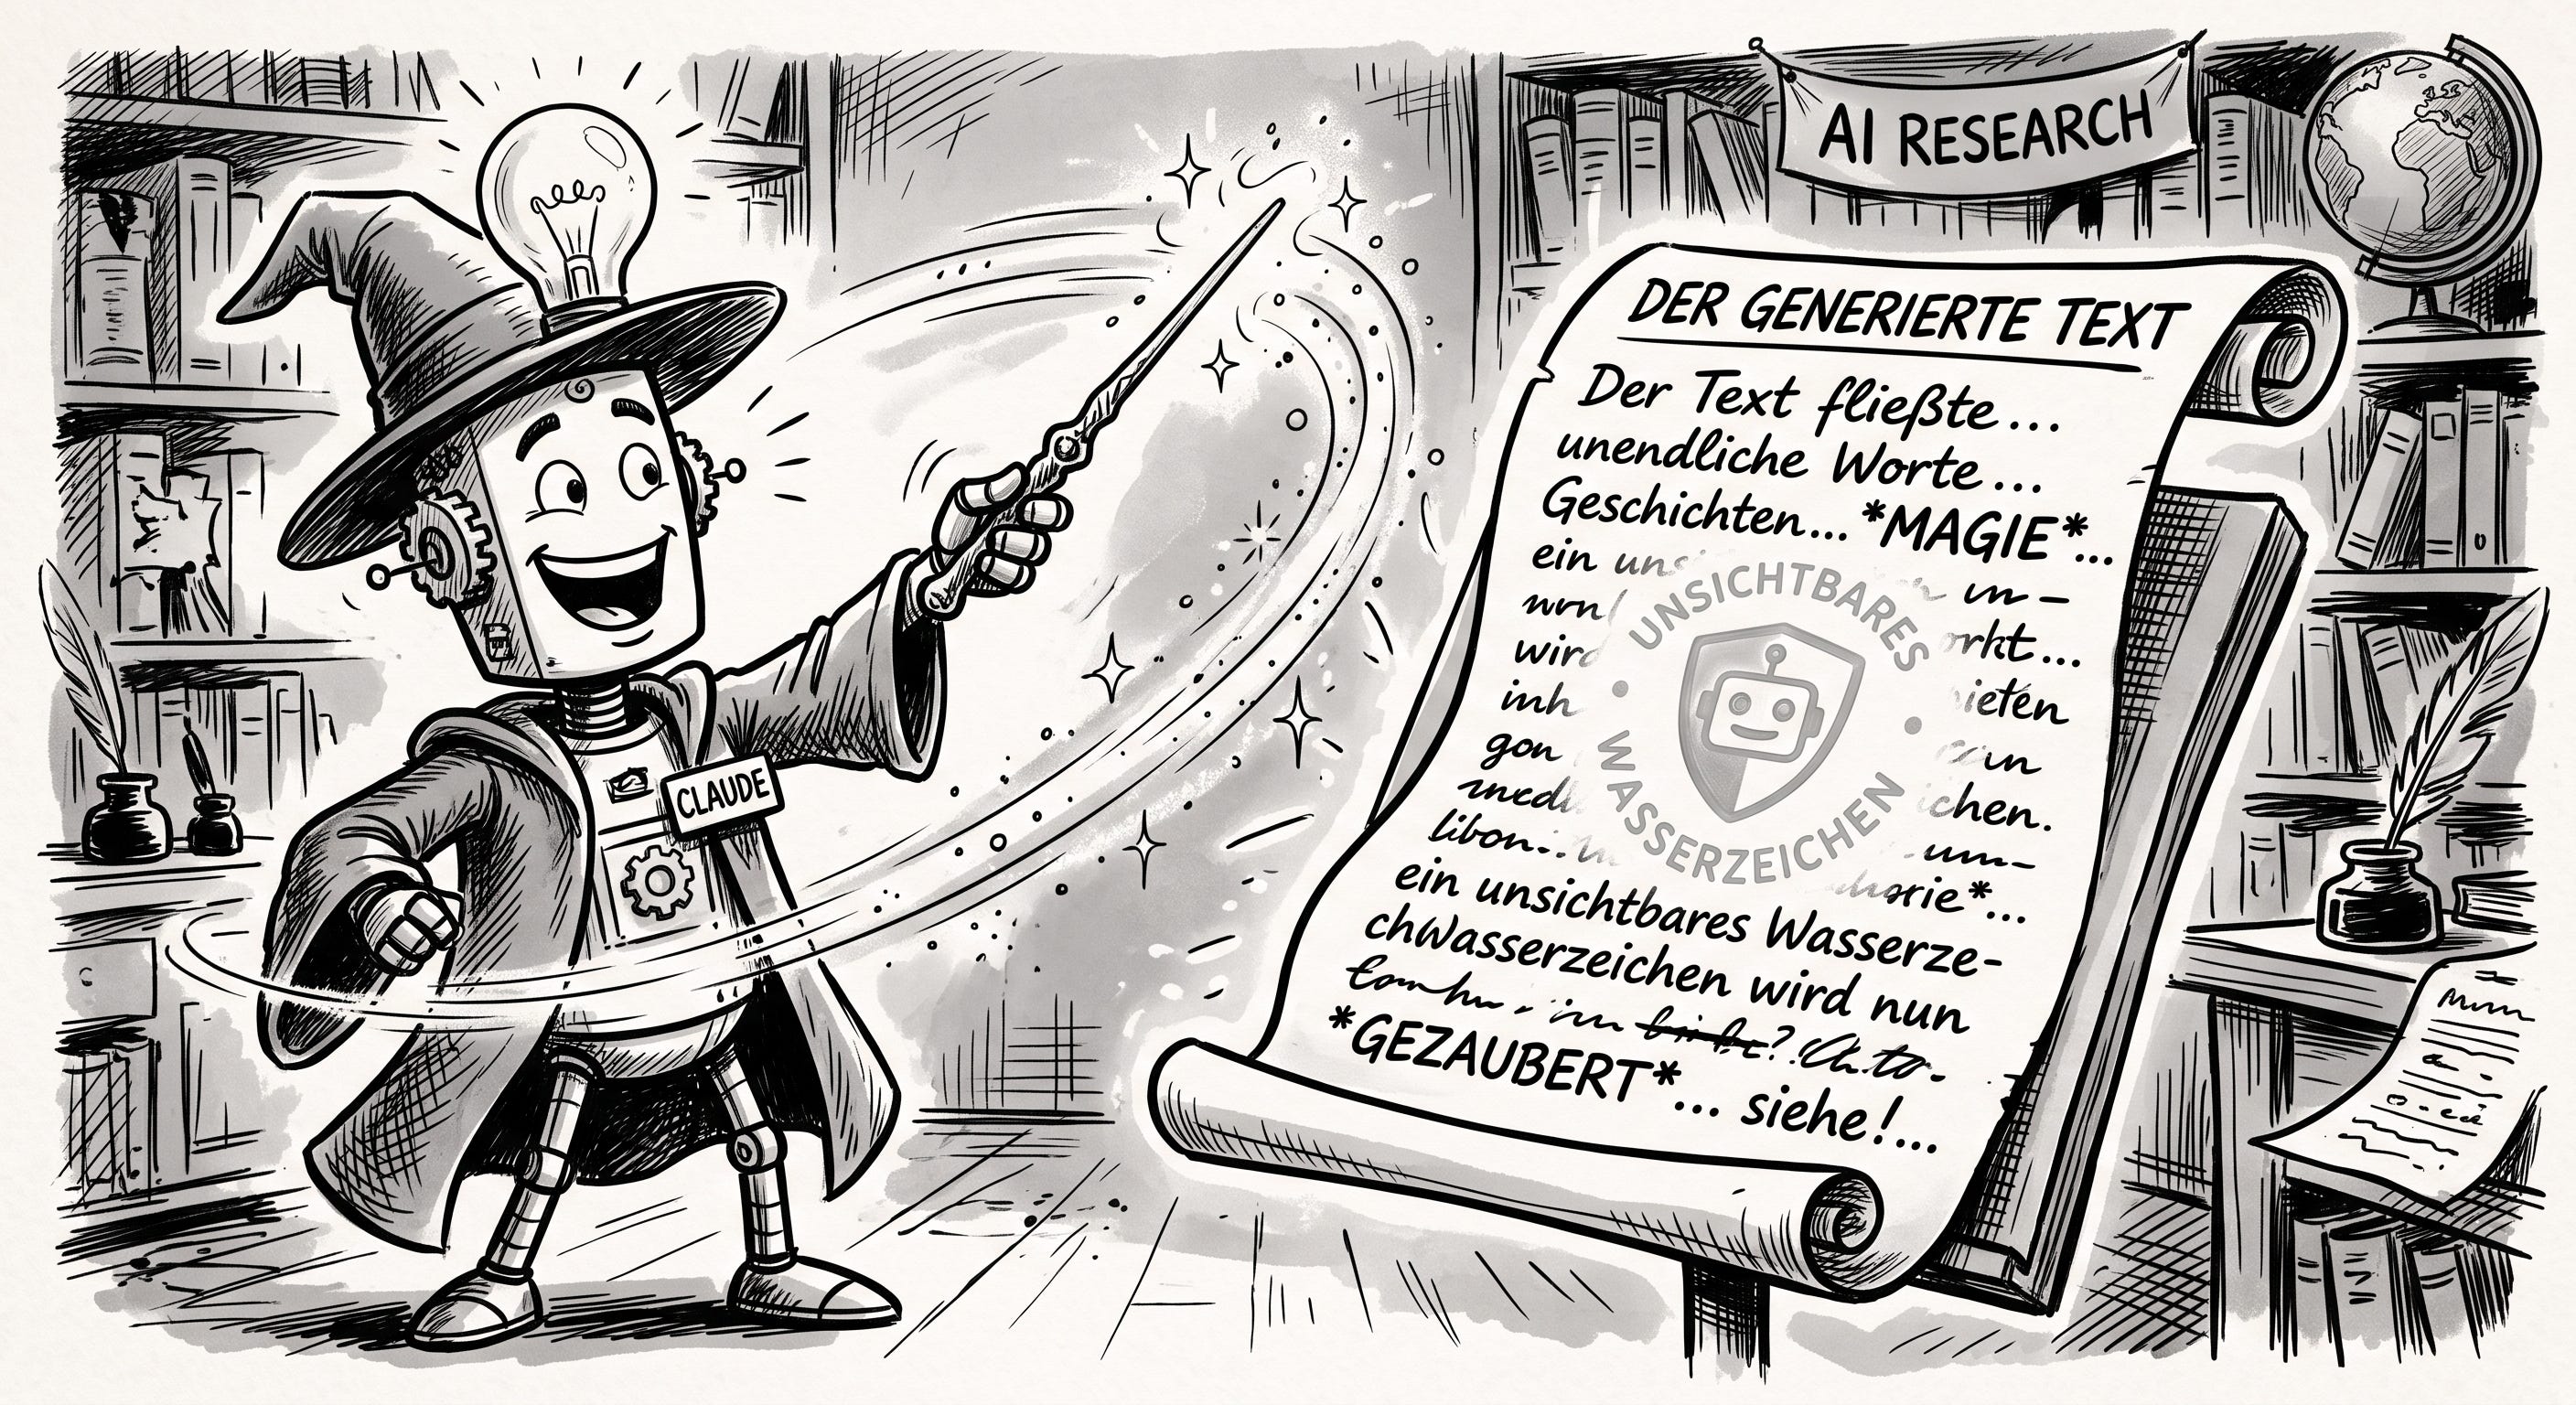
Das Wasserzeichen ist kein verstecktes Zeichen im Text, sondern eine statistische Spur in der Wortwahl selbst: unsichtbar beim Lesen, nachweisbar nur mit einem geheimen Schlüssel, den bislang ausschließlich Anthropic besitzt.
Ein gefundenes Wasserzeichen beweist nicht, dass Claude den Text geschrieben hat – nur, dass der Text irgendwann Claude berührt hat. Das kann auch bloßes Korrekturlesen gewesen sein.
Kein Wasserzeichen heißt ebenso wenig „garantiert menschlich”: kurze Texte, starke Überarbeitung, Übersetzungen mit wenig Spielraum oder ältere Modelle liefern oft kein nachweisbares Muster.
OpenAI hat sich zur Kennzeichnung verpflichtet, aber bislang nichts Vergleichbares live geschaltet. Google hat die zugrunde liegende Technik SynthID-Text selbst entwickelt, offenbar auch in Gemini bereits im Einsatz. xAI/Grok hat den EU-Kodex gar nicht erst unterschrieben.
Der Promptologe hält das Wasserzeichen für ein nützliches, aber leicht überschätztes Signal – und verweist auf eine Feinheit im Gesetzestext, die in der Debatte kaum vorkommt.
Ein Freitagnachmittag Mitte August, und plötzlich ist ein Wort in aller Munde, das bisher vor allem auf Geldscheinen und in Fotolizenzen vorkam: Wasserzeichen. Anthropic kündigt an, in Claude-Texte künftig eine unsichtbare Markierung einzuweben. LinkedIn überschlägt sich. Tagesschau und Heise greifen die Meldung auf, ein paar Tage später folgte ein ausführlicher Erklär-Blogpost von Anthropic selbst. Der Ton in den Kommentarspalten: Verwirrung. Bei LinkedIn gern stündlich breitbeinige Posts von “Thought Leaders in” und “Chief Visionaries of”, mit einem Satz pro Absatz, jeder davon fünf Worte lang und Emoji an Anfang. Braucht es da wirklich noch eine Kennung?
Aber zurück zu Claude: Was genau wird da markiert? Sieht man das? Und heißt das jetzt, jeder KI-Text fliegt künftig auf?
Kurze Antwort: Nein. Aber die lange Antwort lohnt sich, gerade weil sie zeigt, wieviel Interpretationsspielraum ein technisches Detail eröffnen und wieviel Verwirrung es anrichten kann, sobald Gesetzgeber und Marketing-Abteilungen gleichzeitig draufschauen.
Was ist eigentlich passiert
Seit dem 2. August 2026 verlangt der EU AI Act (Artikel 50) von Anbietern generativer KI-Systeme, ihre Ausgaben maschinenlesbar zu kennzeichnen – so, dass Software erkennen kann, ob ein Bild, ein Video, eine Tonspur oder eben ein Text künstlich erzeugt wurde. Rund 190 Unternehmen haben dazu im Juli den freiwilligen „Code of Practice on Transparency of AI-Generated Content” unterschrieben, darunter Anthropic, Google, Microsoft, Meta, Mistral und OpenAI (Elon Musks Pöbel-AI Grok hat den EU-Kodex gar nicht erst unterschrieben). Anthropic war der Erste, der öffentlich und im Detail erklärte, wie es die Auflage bei Claude umsetzt: mit einem Wasserzeichen, das direkt in den generierten Text einfließt, sowie mit signierten Herkunftsdaten (nach dem offenen C2PA-Standard) in generierten Dateien wie Bildern oder SVGs. Die Regel gilt für alle Claude-Modelle, die seit dem 2. August erschienen sind, weltweit – nicht nur für europäische Nutzer, weil Anthropic nach eigener Aussage noch keinen verlässlichen Weg hat, das technisch nach Region zu unterscheiden.
Wie ein Wasserzeichen in Text überhaupt funktionieren soll
Hier hakt es meistens beim Verständnis, verständlicherweise: Ein Foto hat Pixel, in denen man Information verstecken kann. Ein Text hat nur Buchstaben, und Buchstaben sind Buchstaben. Wo soll da ein Wasserzeichen hin, ohne dass es sichtbar wird?
Die Antwort liegt nicht in den Zeichen, sondern in der Entscheidung, die das Modell bei jedem einzelnen Wort trifft. Claude erzeugt Text Wort für Wort und wählt dabei ständig zwischen mehreren passenden Kandidaten. Nach „Das Wetter war heute kalt und…” ist „grau” ungefähr so wahrscheinlich wie „bewölkt” – für die Bedeutung des Satzes macht es wenig Unterschied, welches der beiden Wörter am Ende steht. Normalerweise entscheidet in solchen Fällen der Zufall. Beim Wasserzeichen wird dieser Zufall durch einen geheimen Schlüssel ersetzt: Claude wählt weiterhin scheinbar zufällig, aber die Wahl folgt jetzt einem Muster, das nur erkennt, wer den Schlüssel besitzt. Anthropic vergleicht das selbst mit einem Gesellschaftsspiel, bei dem man statt eines Würfels die Nachkommastellen von Pi zum Ziehen der Zahlen verwendet: Für die Mitspieler ändert sich nichts, die Zahlenfolge erscheint zufällig. Aber wer die Reihe von Pi kennt, kann im Nachhinein nachrechnen, ob tatsächlich Pi im Spiel war.
Wichtig dabei: Das Verfahren ist keine Anthropic-Erfindung. Es basiert auf SynthID-Text, einer Methode, die Google DeepMind 2024 in der Fachzeitschrift „Nature” veröffentlicht hat – eine kleine Pointe am Rande, dazu gleich mehr. Anthropic betont mehrfach, dass die Technik keine zusätzlichen Rechenschritte oder Kosten verursacht, keine Zeichen im Text versteckt und nichts über einzelne Nutzer, Organisationen oder Chats verrät. Bei Programmcode oder Fakten mit nur einer richtigen Antwort – „2 + 2 =” hat schließlich kein gleichwertiges Alternativwort – greift der Mechanismus praktisch nicht, weil es dort keine echte Wahl gibt, in die sich ein Muster einweben ließe.
Was das Wasserzeichen nicht kann
Genau hier wird es interessant, denn die Grenzen sind mindestens so wichtig wie die Funktion selbst. Ein erkanntes Wasserzeichen zeigt nur, dass Claude irgendwann den Text berührt hat – nicht, dass Claude ihn verfasst hat. Wer einen selbstgeschriebenen Absatz zur Rechtschreibprüfung an Claude schickt, bekommt möglicherweise einen Text zurück, der ebenfalls markiert ist, obwohl fast jedes Wort vom Menschen stammt. Anthropic schreibt das selbst so offen wie selten in einer Unternehmensmitteilung: Das Wasserzeichen unterscheidet nicht zwischen „Claude hat das geschrieben” und „Claude hat das überarbeitet”.
Umgekehrt gilt: Kein Wasserzeichen bedeutet nicht automatisch „von Menschenhand”. Kurze Textschnipsel liefern zu wenig Wortentscheidungen für ein verlässliches Muster, starke Umformulierungen oder Übersetzungen durch Dritte verwässern es, und Modelle, die vor dem 2. August erschienen sind, markieren bislang gar nicht – Anthropic arbeitet nach eigenen Angaben daran, das in den kommenden Monaten nachzurüsten. Eine öffentlich nutzbare Prüf-Software für Text gibt es noch nicht; Anthropic kündigt eine „Watermark Detection API” an, ohne bislang einen Termin zu nennen. Bis dahin lässt sich von außen niemand nachprüfen, wie stark das Signal in einem bestimmten Text tatsächlich ist – der Sicherheitsforscher und Blogger Daniel Miessler weist zu Recht darauf hin, dass Anthropic weder Algorithmus noch Detektor veröffentlicht hat, seine eigene Analyse also Rekonstruktion bleibt, kein bestätigter Fakt.
Genau an diesem Punkt wird auch aus deutscher Fachpresse Skepsis laut. Heise kommentiert, das Wasserzeichen berge das Risiko einer „falschen Brandmarkung”: Wer einen selbst geschriebenen Text nur an wenigen Stellen von Claude glätten lässt, muss damit leben, dass der gesamte Text pauschal als KI-Erzeugnis erkennbar sein könnte – während umgekehrt das Fehlen eines Wasserzeichens fälschlich als Echtheitssiegel gelesen werden könnte, obwohl genau das nie der Anspruch war. Die Sorge ist nicht die Technik selbst, sondern ihre Überinterpretation: ein Stempel, der in der öffentlichen Wahrnehmung mehr Gewissheit verspricht, als er tatsächlich liefert.
Was das Gesetz wirklich verlangt – und was nicht
An dieser Stelle lohnt ein Blick ins Kleingedruckte, weil in der Debatte zwei verschiedene Pflichten oft durcheinandergehen. Artikel 50 Absatz 2 verpflichtet Anbieter wie Anthropic dazu, ihre Ausgaben maschinenlesbar zu markieren – das ist die Pflicht, die das Wasserzeichen erfüllt, ausnahmslos, bei jedem generierten Wort. Eine ganz andere Pflicht, Artikel 50 Absatz 4, richtet sich an diejenigen, die KI-generierten Text veröffentlichen, um die Öffentlichkeit über Angelegenheiten von öffentlichem Interesse zu informieren – etwa Redaktionen. Sie müssen offenlegen, dass ein Text künstlich erzeugt wurde. Es sei denn: Der Inhalt wurde einer menschlichen Überprüfung oder redaktionellen Kontrolle unterzogen, und eine natürliche oder juristische Person trägt die redaktionelle Verantwortung für die Veröffentlichung. Dann entfällt die Offenlegungspflicht.
Diese Ausnahme wird in der aktuellen Debatte kaum erwähnt, deckt sich aber verblüffend genau mit einer Haltung, die der Promptologe schon vorher für sich entwickelt hatte, unabhängig vom Gesetzestext: Entscheidend ist nicht, ob eine KI an einem Text mitgeschrieben hat, sondern ob ein Mensch dafür geradesteht – ihn verantwortet, weil er seinen eigenen Ansprüchen genügt. Das ist ausdrücklich eine persönliche Position, kein Ratschlag für Redaktionen oder Plattformen, und sie gilt nur für Text, nicht für Bild, Ton oder Video, wo Herkunft aus anderen Gründen sehr wohl zählt, etwa bei Deepfakes. Aber es ist bemerkenswert, dass der Gesetzgeber an dieser einen Stelle zu einem ähnlichen Schluss kommt wie die eigene Praxis: Wasserzeichen hin oder her, wer verantwortet, was veröffentlicht wird, bleibt der Mensch.
Wie es die Konkurrenz hält
Anthropic war lauter und schneller als alle anderen, aber nicht allein. OpenAI hat sich im Rahmen desselben EU-Kodex verpflichtet, „Herkunftssignale auf alle Modalitäten einschließlich Text auszuweiten”, wie es aus dem Unternehmen heißt – ein Vorhaben, keine fertige Umsetzung. Bemerkenswert ist die Vorgeschichte: OpenAI hatte bereits 2024 eine eigene Text-Wasserzeichen-Technik intern getestet und dann auf Eis gelegt, nachdem eine eigene Umfrage ergeben hatte, dass fast 30 Prozent der Befragten ChatGPT seltener nutzen würden, wenn ihre Texte markiert würden. Ob und wann ein vergleichbares System live geht, ist derzeit offen.
Google hat, wie erwähnt, die technische Grundlage überhaupt erst geliefert: SynthID-Text stammt aus dem eigenen Forschungslabor DeepMind und wurde bereits 2024 quelloffen zur Verfügung gestellt. Auf offizielle Nachfrage im Google-Entwicklerforum bestätigte ein Google-Mitarbeiter Mitte August – nach zunächst gegenteiliger Auskunft –, dass über die Gemini-API erzeugter Text tatsächlich mit SynthID markiert wird. Eine öffentlich dokumentierte, verbindliche Aussage für alle Gemini-Oberflächen fehlt aber bislang, ebenso ein für alle nutzbares Prüfwerkzeug für Text. Google selbst warnt in seiner eigenen Stellungnahme zum EU-Kodex zugleich vor „zu vielen überlappenden KI-Kennzeichnungen”, die die Transparenz eher erschweren als fördern könnten – ein Einwand, der nicht ganz uneigennützig ist, aber in der Sache nicht falsch.
Elon Musks xAI mit seiner Pöbel-AI Grok wiederum hat den EU-Kodex bislang nicht unterzeichnet – als einziger der großen Anbieter. Das befreit nicht von der gesetzlichen Pflicht selbst, verschiebt aber die Frage, wie und wann Grok sie erfüllt.
Realitäts-Check
Was bleibt, wenn man den Hype beiseiteräumt: ein technisch cleveres, wirklich unauffälliges Verfahren, das ein ehrliches, aber begrenztes Signal liefert – eher ein Indizienbeweis als ein Nachweis. Es kann helfen, plumpe Massenware zu entlarven, gefälschte Rezensionen etwa oder Bot-Netzwerke, die in großem Stil Text produzieren. Es kann nicht sagen, wer wirklich am Steuer saß, als ein bestimmter Satz entstand. Und weil bislang niemand außerhalb von Anthropic den Algorithmus prüfen oder gegenrechnen kann, bleibt vorerst auch die zentrale Frage offen, wie robust das Ganze tatsächlich ist, wenn jemand es wirklich austricksen will.
Es ist, in gewisser Weise, typisch für das Tempo dieser Branche: Ein europäisches Gesetz, über Jahre verhandelt, trifft auf eine technische Umsetzung, die binnen weniger Wochen aus dem Boden gestampft wird – Ankündigung, Erklär-Blogpost, Kritik, Klarstellung, alles in derselben Woche. Der Hyperschall-Kapitalismus kennt offenbar auch bei der Regulierung nur eine Geschwindigkeit. Staunenswert ist trotzdem, wie elegant das Verfahren technisch gelöst ist – eine Markierung, die buchstäblich nichts kostet und nichts verändert. Nur sollte man ihr nicht mehr zutrauen, als sie leisten kann.
Quellen
How Claude’s text watermark works – Anthropic, offizielle Ankündigung, 14.08.2026
Wie Claude KI-generierte Inhalte kennzeichnet – Claude Help Center
Anthropic führt Wasserzeichen bei KI-Texten ein – Tagesschau, 12.08.2026
Keine Chance für Schummler: Claude bekommt jetzt ein unsichtbares Wasserzeichen – Heise
Claude: KI-Wasserzeichen – ein Bärendienst für die Wahrheit – Heise, Kommentar
Where an AI Watermark Can Hide in Plain Text – Daniel Miessler
Anthropic To Mark Claude Text & Files Under EU AI Act Code – Search Engine Journal
ChatGPT to follow Claude’s watermark pledge – but Grok to swerve it – City A.M.
Google is signing the EU AI Act Code of Practice on Transparency of AI-Generated Content – Google
Does Gemini API text output carry SynthID watermarking? (EU AI Act Art 50(2)) – Google AI Developers Forum
Scalable watermarking for identifying large language model outputs – Google DeepMind, Nature, 2024 (SynthID-Text)
Google will now allow users to remove visible watermarks from AI content – Engadget
Artikel 50: Transparenzverpflichtungen für Anbieter und Betreiber bestimmter KI-Systeme – artificialintelligenceact.eu (Future of Life Institute), Originaltext
Der Promptologe, 20.08.2026
Offenlegung - hier besonders selbstreferentiell:
Dieser Beitrag entstand mit Hilfe von Anthropic Claude. Wie alle
Beiträge in dieser Reihe, und von anfang an vermerkt.