

Nano Banana 2, Prompt: Der Promptologe
Kurz zusammengefasst, für alle mit wenig Zeit:
KI-Detektoren messen Schreibstil, nicht Herkunft. Unabhängige Studien finden Fehlerquoten von 13 bis 29 Prozent – während Anbieter mit “99,9 % Genauigkeit” werben.
Das EU-KI-Gesetz verlangt seit dem 2. August Kennzeichnung von KI-Inhalten – enthält aber eine Ausnahme: Wer als Mensch redaktionell verantwortlich zeichnet, muss den KI-Anteil nicht offenlegen.
Wer fälschlich der KI-Nutzung verdächtigt wird, kann das Gegenteil nicht beweisen. Reale Fälle – ein Student, ein Schüler, eine Autorin – zeigen, was das bedeutet.
Substack (mit Pangram) und LinkedIn reagieren auf dieselbe Verunsicherung mit gegensätzlichen Mitteln: Prozentzahl versus Meldeknopf.
Meine persönliche Haltung am Schluss: Entscheidend ist nicht der KI-Anteil, sondern ob ein Mensch für den Text geradesteht.
Am 2. August ist das EU-KI-Gesetz mit seinen Kennzeichnungspflichten in Kraft getreten. Knapp zwei Wochen zuvor hat Substack einen KI-Detektor in die eigene Plattform eingebaut. Und LinkedIn, das seinen Nutzer:innen jahrelang bereitwillig Schreibassistenten in die Timeline gestellt hat, verabschiedet sich gerade selbst wieder davon. Drei Reflexe auf dieselbe Verunsicherung, drei völlig unterschiedliche Mittel – ein Gesetz, ein Prozentwert, ein Meldeknopf. Und mittendrin eine Frage, die keines dieser drei Mittel beantworten kann: Wie beweist man, dass man ein Mensch ist?
Die englische Version:

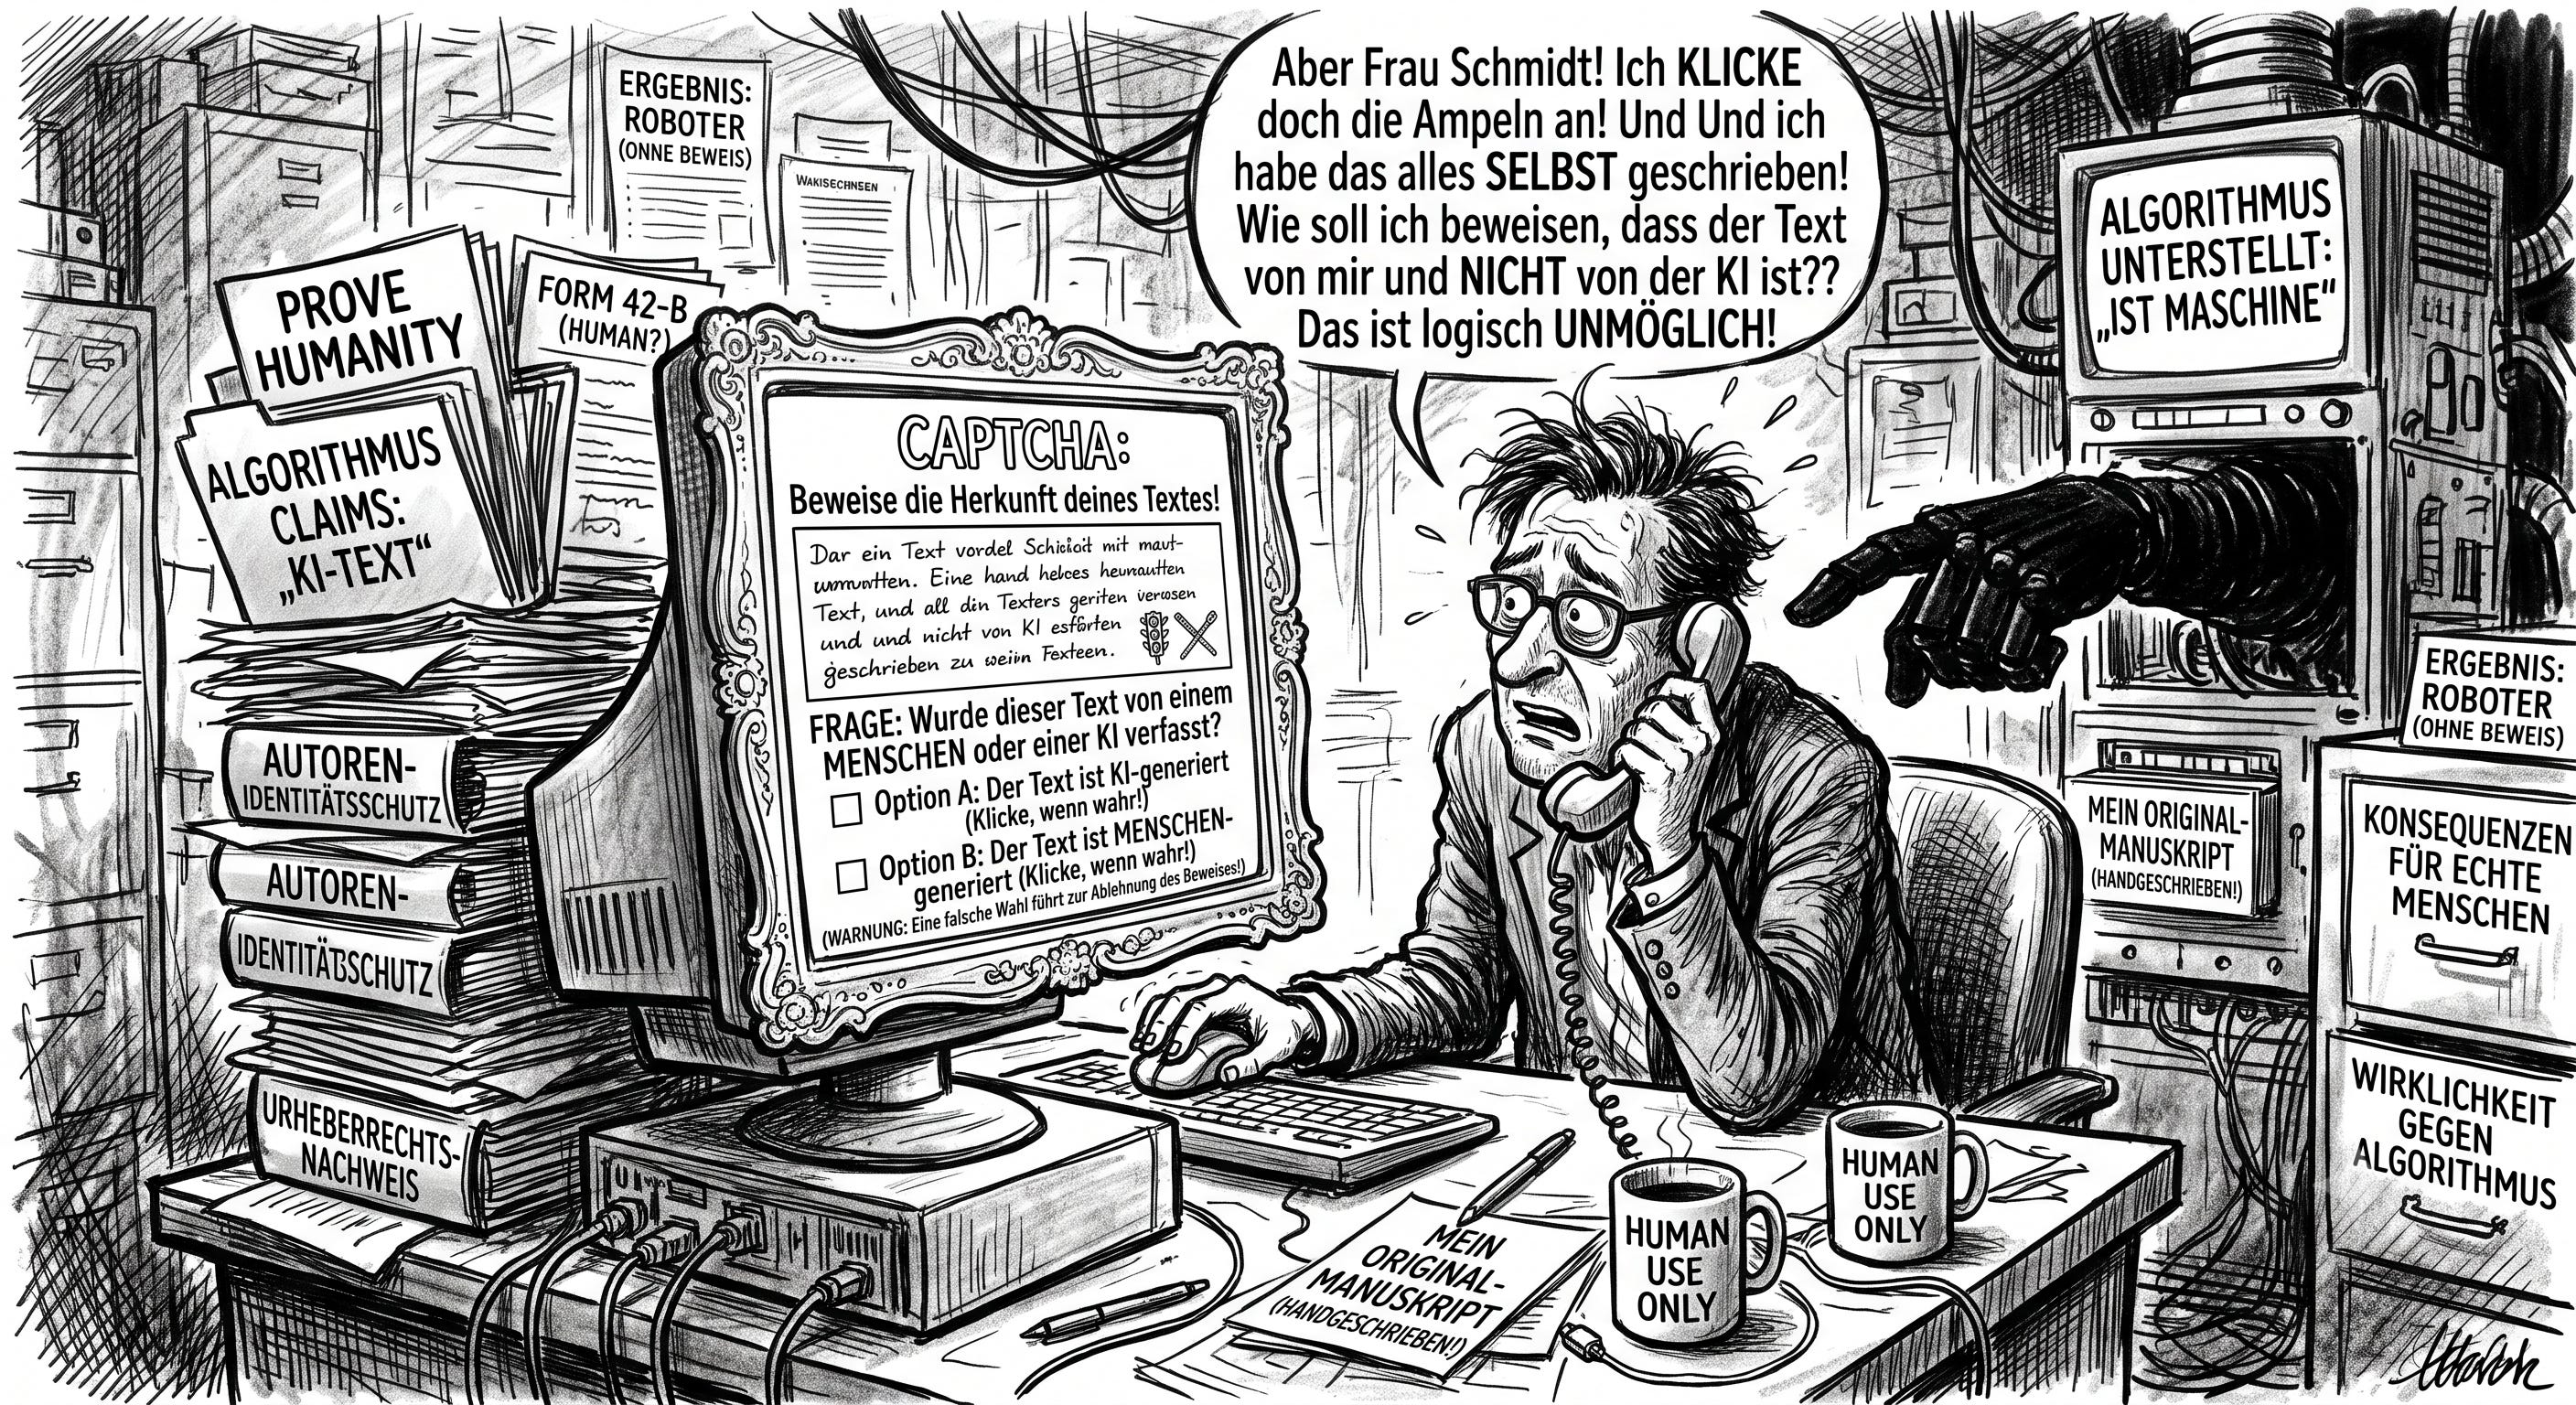
Diese Frage kennen wir eigentlich umgekehrt, aus jedem zweiten Onlineformular: Beweis, dass du kein Roboter bist, klick die Ampeln an. Was früher eine lästige Fleißaufgabe war, ist gerade dabei, zu einer ernsten Angelegenheit zu werden – mit echten Konsequenzen für echte Menschen, die plötzlich das Gegenteil beweisen sollen von dem, was ihnen ein Algorithmus unterstellt. Nur: Einen Negativbeweis gibt es nicht. Das ist keine Marotte der Logik, das ist ihr Grundprinzip. Und genau daran zerschellt gerade ein ganzer, gehypter Markt.
Was ein KI-Detektor tatsächlich misst
Fangen wir mit der nüchternen Bestandsaufnahme an, denn die braucht es, bevor wir uns über irgendetwas aufregen dürfen. Ein KI-Detektor liest keinen Ursprung. Er liest Muster: wie vorhersehbar die Wortwahl ist, wie gleichmäßig die Sätze gebaut sind, wie glatt der Rhythmus fließt. Das sind Eigenschaften, die Sprachmodelle mit hoher Wahrscheinlichkeit erzeugen – aber auch Eigenschaften, die ein Mensch mit gutem Lektorat und ordentlicher Selbstdisziplin ganz von allein hinbekommt. Der Detektor beantwortet also nicht die Frage “Hat das eine Maschine geschrieben?”, sondern “Klingt das so, wie Maschinen zu klingen pflegen?” Das ist ein Unterschied, der in der öffentlichen Debatte notorisch unter den Tisch fällt.
Wie groß dieser Unterschied in der Praxis ausfällt, hat die Forschungsorganisation Epoch AI im Juli 2026 systematisch vermessen. Getestet wurden drei der meistgenutzten Werkzeuge – Pangram, GPTZero und Originality.ai – an über tausend Textproben, halb menschlich, halb maschinell erzeugt. Das Ergebnis ist aufschlussreich in beide Richtungen. Bekommt ein Sprachmodell eine simple Aufforderung wie “Schreib eine kurze Geschichte über einen verlorenen Hund”, erkennen alle drei Tools die Maschine fast fehlerfrei. Bekommt dasselbe Modell dagegen fünf Textproben einer echten Autorin und den Auftrag, deren Stil nachzuahmen, rutscht die Erkennung auf 82 bis 90 Prozent ab – eine Lücke von 10 bis 18 Prozent. Bei wissenschaftlichen Texten wird es noch unschärfer: Hier verfehlen die Detektoren zwischen 24 und 29 Prozent der KI-Texte, in einzelnen Kombinationen sogar fast jeden zweiten. Der Grund ist so simpel wie unbequem: Wissenschaftliche Prosa ist ohnehin schon standardisiert, passiv, floskelhaft – womit genau jene statistische Unregelmäßigkeit fehlt, an der die Detektoren sich normalerweise festbeißen.
Und die Kehrseite? Falsch-positive Urteile, bei denen echte Menschen als Maschine verdächtigt werden, kommen laut derselben Studie bei Pangram und GPTZero praktisch nicht vor – bei Originality.ai dagegen bei 3,8 Prozent aller menschlichen Texte, bei Belletristik sogar bei jedem zehnten. Eine ähnliche Hausnummer liefert ein Praxistest, den das Fachmagazin Digital Publishing Technologien im Mai 2026 unter dem Titel “Die Text-DNA” veröffentlicht hat: rund 15 Prozent falscher Verdächtigungen bei den gängigen Detektoren – jede sechste bis siebte zu Unrecht beschuldigte Person. Zitiert wird dort auch ein Fall aus dem eigenen Metier: Die FAZ nahm im Juni 2026 einen Gastbeitrag wieder offline, nachdem ein KI-Detektor angeschlagen hatte – mit dem bemerkenswert ehrlichen Zusatz der Redaktion, das genutzte Werkzeug sei “mitnichten perfekt” und liefere “keinen endgültigen Beweis”. Genau. Und trotzdem war der Text erst einmal weg.
Wer sich täuschen lassen will, kann es im Übrigen mühelos. Stimmt man ein Sprachmodell gezielt auf einen bestimmten menschlichen Stil ein, fällt die Trefferquote der Detektoren in besagtem Praxistest von 97 auf 3 Prozent. Die Werkzeuge treffen also, zugespitzt gesagt, vor allem die Unbedarften – nicht die, die wirklich täuschen wollen. Forschungsteams arbeiten unterdessen an tieferliegenden Merkmalen, die nicht den Stil, sondern die Erzähl- und Denkstruktur eines Textes vermessen und selbst nach Politur noch zu über 90 Prozent KI erkennen sollen. Nur: Das ist Forschungsstand, kein Produkt, das man heute für 19 Euro im Monat abonnieren kann.
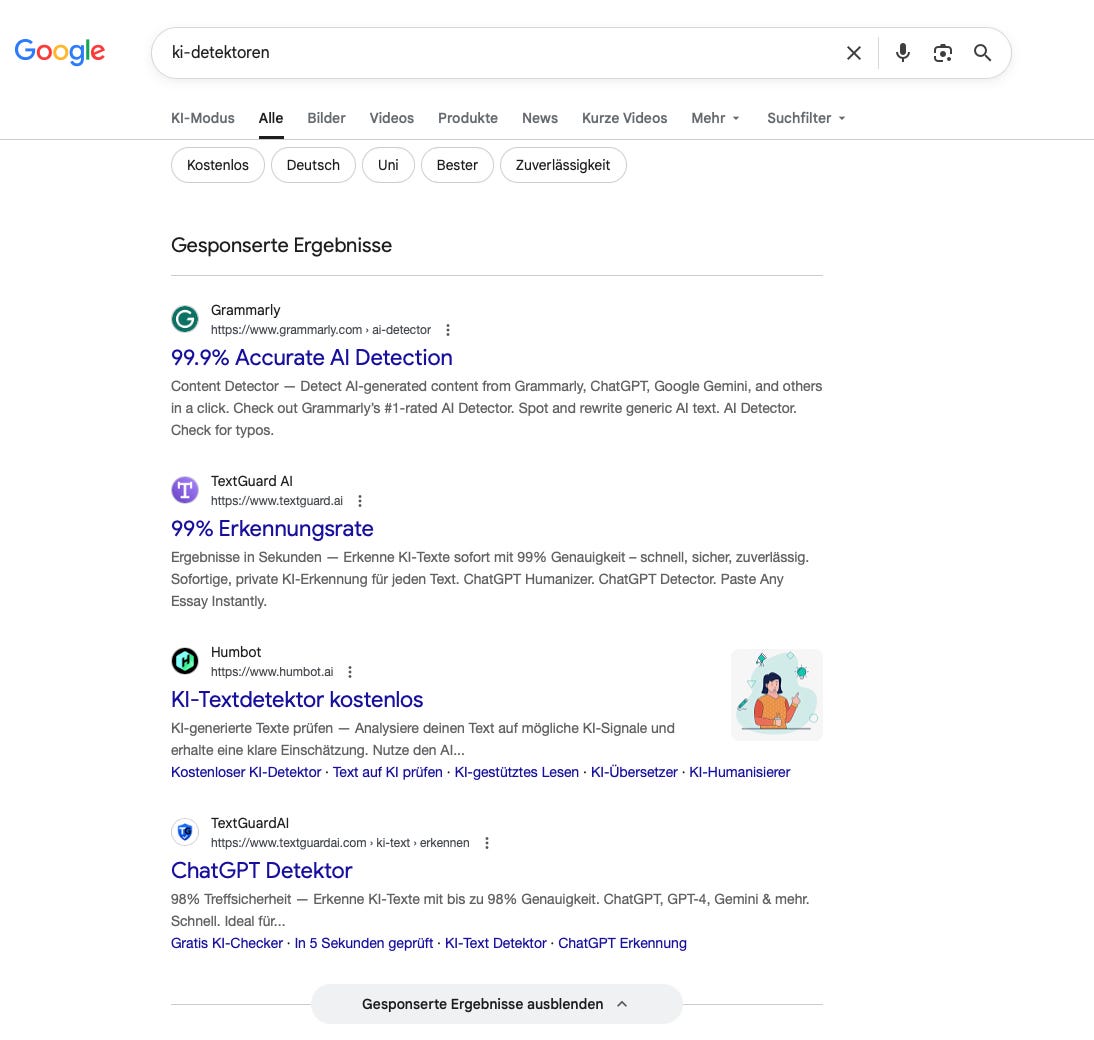
99,9% Trefferquote: Schamlos gelogen oder Marketing?
Screenshot Ser Promptologe
Was man dagegen abonnieren kann, zeigt ein Blick in die eigene Google-Suche. Die obersten Treffer für “KI-Detektoren” sind ausnahmslos bezahlte Anzeigen: Grammarly wirbt mit “99,9 % Accurate AI Detection”, ein Anbieter namens TextGuard AI mit “99 % Erkennungsrate”, ein anderer mit “98 % Treffsicherheit”. Gemessen an dem, was Epoch AI unabhängig gemessen hat, sind das keine Übertreibungen mehr, sondern Zahlen, die hart an der Grenze zur Irreführung entlangschrammen. Es ist diese Art von Zahlenspiel, die den Hyperschall-Kapitalismus der Branche ausmacht: Wachstum first, Wahrheitsgehalt später, wenn überhaupt.
Für Bild, Ton und Video gilt im Prinzip dasselbe Grundproblem, nur mit anderen Anbietern. Hive AI und Reality Defender kommen bei Bild- und Video-Deepfakes auf offiziell rund 98 Prozent Trefferquote, Letzterer über eine gemeinsame Schnittstelle für Bild, Video, Ton und Text. Bei Audio tun sich vor allem Anbieter wie Pindrop hervor, spezialisiert auf Stimmklone – allerdings mit deutlich wackligeren Zahlen, sobald es um kurze, komprimierte Clips geht, wie sie in Podcasts oder am Telefon anfallen. Und bei Video ist die größte Schwachstelle banal: Kompression. Ein Video, das durch Instagram oder TikTok gejagt wurde, lässt sich schlechter prüfen als das Original – Erkennungssoftware und Plattformlogik arbeiten sich gegenseitig entgegen.
Was das Gesetz wirklich verlangt
Seit dem 2. August gilt Artikel 50 des EU-KI-Gesetzes. Um ihn richtig einzuordnen, lohnt sich ein Blick in den Originaltext statt in die x-te Zusammenfassung – ich habe mir den Gefallen getan. Die Kurzfassung: Das Gesetz löst nicht das Erkennungsproblem, es verschiebt es. Statt der (technisch unlösbaren) Frage “Kann man es erkennen?” stellt die EU die administrative Frage “Wer muss es wann und wie kenntlich machen?”
Konkret verpflichtet Absatz 2 die Anbieter von KI-Systemen, die synthetische Audio-, Bild-, Video- oder Textinhalte erzeugen, ihre Ausgaben maschinenlesbar zu kennzeichnen – “soweit technisch machbar”. Ausdrücklich ausgenommen sind Systeme, die nur eine “Hilfsfunktion für die Standardredaktion” erfüllen oder die Eingaben der Nutzer:innen nicht wesentlich verändern. Unter diese Formulierung fällt ziemlich genau das, worauf LinkedIn seine Schreibhilfe gerade zurückgestutzt hat: reine Rechtschreibprüfung statt Umformulierung.
Interessanter wird es in Absatz 4, dem eigentlichen Kern der öffentlichen Debatte. Deepfakes in Bild, Ton oder Video müssen offengelegt werden, wobei bei offensichtlich künstlerischen, satirischen oder fiktionalen Werken ein dezenter Hinweis genügt, der den Genuss nicht stört. Bei Texten zu Themen von öffentlichem Interesse gilt grundsätzlich dasselbe – mit einer Ausnahme, die ich für die eigentlich entscheidende Stelle des ganzen Paragrafen halte: Die Kennzeichnungspflicht entfällt, wenn der Inhalt einer menschlichen Überprüfung oder redaktionellen Kontrolle unterzogen wurde und eine natürliche oder juristische Person die redaktionelle Verantwortung für die Veröffentlichung trägt.
Lesen Sie das gern zweimal. Der europäische Gesetzgeber, dem man Technikferne vorwerfen kann, aber selten mangelnden Sinn fürs Grundsätzliche, entscheidet sich hier explizit gegen den KI-Anteil als Kriterium und für die menschliche Verantwortung. Nicht wie viel Maschine im Text steckt, ist die entscheidende Frage, sondern wer dafür geradesteht. Das ist bemerkenswert unaufgeregt für ein Gesetz, das öffentlich vor allem als Kennzeichnungspflicht verhandelt wird – und es ist, das sei an dieser Stelle schon verraten, eine Position, der ich mich am Ende dieses Textes explizit anschließen werde.
Was das Gesetz nicht tut: Es ersetzt keine nachträgliche Erkennung. Wasserzeichen lassen sich entfernen, Kennzeichnungspflichten werden nicht von allen befolgt, und wer sich nicht daran hält, verlässt sich darauf, dass es niemand nachprüft. Genau in diese Lücke stoßen die Detektoren wie Pangram – sie versprechen nachträglich zu leisten, was der Gesetzgeber lieber an der Quelle geregelt hätte.
Der Beweis, den es nicht geben kann
Und damit zum eigentlichen Problem. Wer beschuldigt wird, einen Text mit KI erzeugt zu haben, kann das Gegenteil nicht beweisen. Es gibt keine Methode, mit der eine Person nachträglich zweifelsfrei zeigen kann, dass keine Maschine beteiligt war. Man kann höchstens den eigenen Arbeitsprozess dokumentieren – Versionshistorien, Entwürfe, Recherchenotizen –, und selbst das lässt sich als unzureichend zurückweisen oder, im Ernstfall, fälschen. You can’t prove a negative. Das ist keine neue Erkenntnis, aber sie bekommt gerade neue, sehr konkrete Opfer.
Im Februar 2026 gewann Orion Newby als erster Student einen Bundesrechtsstreit gegen den Vorwurf, mit KI geschummelt zu haben. Ein Gericht des Staates New York bewertete den Befund seiner Universität, der Adelphi University, als “without valid basis and devoid of reason” – ohne gültige Grundlage und ohne Vernunft. Die Familie zahlte dafür sechsstellige Anwaltskosten. Wenig später reichte eine Familie in Palo Alto Klage ein, nachdem ihr Sohn wegen KI-Verdachts an der Highschool sanktioniert worden war. Mittlerweile sind mindestens fünf solcher Bundesklagen dokumentiert, und mehr als 25 Universitäten, darunter MIT, Yale und die UC Berkeley, haben KI-Detektoren im akademischen Betrieb inzwischen eingeschränkt oder ganz verboten.
Das Problem endet nicht an der Uni-Pforte. Die britische Autorin Mia Ballard hatte ihren Thriller “Shy Girl” im Selfpublishing zum Erfolg gemacht, bis der Verlag Hachette ihn ins reguläre Programm übernahm. Nach Verdachtsäußerungen aus dem Netz kamen drei verschiedene KI-Detektoren zu dem Schluss, das Buch sei höchstwahrscheinlich mit Maschinenhilfe entstanden. Hachette zog den Titel zurück, die New York Times berichtete, Ballard bestreitet den Vorwurf bis heute. Ob sie recht hat, wird niemand je beweisen können – weder sie noch der Verlag. Genau das ist der Punkt.
Diese Fälle sind keine Randnotizen, sie sind der Systemfehler, der entsteht, wenn eine Wahrscheinlichkeitsaussage als Beweismittel behandelt wird. Ein Detektor liefert eine Zahl. Eine Institution macht daraus ein Urteil. Und die betroffene Person steht plötzlich in der Position, etwas widerlegen zu müssen, das sich per Definition nicht widerlegen lässt.
Substack, Pangram und eine anonyme Stimme, der ich zustimme
Mitten in diese Gemengelage hinein hat Substack am 21. Juli die Funktion “Auf KI-Text scannen” eingeführt, entwickelt mit dem Anbieter Pangram. Ab 100 Wörtern lässt sich seither jeder Beitrag auf der Plattform scannen; das Ergebnis gibt an, zu wie viel Prozent ein Text wohl künstlich generiert wurde. Angekündigt hat das Substack-Chef Chris Best in einem Beitrag mit dem Titel “Against Claudefishing” – ein Wortspiel auf “Catfishing”, das den Vertrauensbruch treffend beschreibt, den es benennt: Leser:innen investieren Aufmerksamkeit in etwas, hinter dem kein menschliches Denken steckt, ohne es zu wissen. Ein wunder Punkt, zweifellos.
Nur: Das Mittel, das Substack anbietet, ist genau das Mittel, das im vorigen Abschnitt beschrieben wurde – mit allen seinen Grenzen. Beworben wird eine Genauigkeit von 99,8 bis 100 Prozent, eine Falsch-Positiv-Rate von rund eins zu zehntausend. Zahlen, die deutlich optimistischer klingen als das, was Epoch AI unabhängig für vergleichbare Werkzeuge gemessen hat – wenn auch nicht direkt vergleichbar, weil andere Version, andere Testbasis. Dazu kommt ein strukturelles Ärgernis, das in den Kommentaren unter der besten Kritik zu diesem Feature auftaucht, die ich kenne: Um den Scanner für die eigene Seite zu deaktivieren, muss man seinen Text zuvor selbst durch ihn laufen lassen – und liefert Pangram damit, ob man will oder nicht, laufend frisches Trainingsmaterial.
Diese Kritik stammt von der anonym bleibenden Autorin Micky, die unter dem Titel “Das Geschäft mit KI-Scores” alles gesagt hat, was zu diesem Thema zu sagen ist, und zwar besser, als ich es hier zusammenfassen könnte. Ihre zentrale Beobachtung: Ein Detektor fällt “ein Urteil über Stil, nicht über die Herkunft” – er beantwortet nicht “Hat eine Maschine das geschrieben?”, sondern “Sieht das so aus, wie Maschinen zu schreiben pflegen?” Und weil Sprachmodelle auf guter, geschliffener Prosa trainiert wurden, wird ausgerechnet der sorgfältig redigierte Text verdächtiger als der rohe. Micky formuliert es so: “Konventionell gut zu schreiben ist damit verdächtiger geworden als eigenwillig zu schreiben.” Wer über Jahre einen sauberen Stil entwickelt hat, riskiert paradoxerweise das schlechtere Ergebnis als jemand, der einfach drauflosschreibt.
Und sie trifft noch einen Punkt, der selten so klar benannt wird: Anbieter wie Pangram verkaufen “nicht Wahrheit, sondern die Befriedigung eines Kontrollbedürfnisses, die Linderung einer Unsicherheit, die ohne sie gar nicht so laut wäre.” Das ist scharf formuliert, und es deckt sich auffällig mit dem, was die unabhängigen Studien aus dem vorigen Abschnitt in trockene Prozentzahlen fassen. Micky hat für sich entschieden, den KI-Score unter ihrem eigenen Artikel abzustellen, “um euch mit euren Einschätzungen allein zu lassen”. Eine Geste, die ich nachvollziehen kann.
LinkedIn: Erst der Dealer, jetzt der Entzugshelfer
Während Substack sein Publikum mit einer neuen Zahl beunruhigt, macht LinkedIn die entgegengesetzte Rolle rückwärts. Über Jahre hat die Plattform generative Schreibhilfen aktiv beworben und in die Timeline gedrückt – mit dem Ergebnis, dass mittlerweile 41 Prozent der langen Beiträge über 250 Wörter und 30 Prozent der kurzen vollständig maschinell erzeugt sind, der höchste KI-Sättigungsgrad unter den großen Plattformen. Die Reaktion darauf kam in diesem Sommer: Die eigene KI-Schreibhilfe wurde eingestampft und durch eine reine Rechtschreibprüfung ersetzt, die nichts mehr umformuliert. Dazu kam ein neuer Meldeknopf mit dem schönen Namen “Appears to be AI-Slop”, der seit Anfang August schrittweise ausgerollt wird.
Das Wall Street Journal berichtete am 7. August von einer weiteren Funktion, die noch kommen soll: Nutzer:innen sollen künftig erfahren, wenn andere ihre Beiträge als “botartig” wahrnehmen – ein Social-Feedback-Mechanismus, der über das reine Melden hinausgeht und Verhalten direkt über soziale Rückmeldung steuern will. Man kann das als konsequent lesen oder als leicht groteske Wendung: Dieselbe Plattform, die ihre Nutzer:innen erst systematisch an KI-Formulierungshilfen gewöhnt hat, bringt ihnen jetzt bei, wie man nicht wie eine KI klingt. Der Dealer, der plötzlich Entzugsberatung anbietet – wobei LinkedIn interessanterweise weiterhin eigene KI-Funktionen betreibt, während es fremde KI-Inhalte bekämpft. Diese Doppelrolle als Anbieter und Kontrolleur verdient eine eigene Randbemerkung, unabhängig von der technischen Detektionsfrage.
Nüchterne Bilanz
Was bleibt, wenn man Marktüberblick, Gesetzestext und die konkreten Schicksale zusammenlegt? Ein KI-Detektor ist ein Stilanalyse-Werkzeug mit einer Fehlerquote, die irgendwo zwischen “spürbar” und “erheblich” liegt, je nachdem, welchen Text man ihm vorlegt und welchen Anbieter man fragt. Er kann ein Hinweis sein, kein Urteil. Der EU AI Act verpflichtet zur Kennzeichnung an der Quelle, nicht zur nachträglichen Aufklärung – und er räumt selbst ein, dass menschliche redaktionelle Verantwortung wichtiger ist als der reine KI-Anteil. Und überall dort, wo Institutionen diese Nuance ignorieren und aus einer Wahrscheinlichkeit ein Urteil machen, entstehen reale Schäden bei Menschen, die sich gegen einen Vorwurf nicht wehren können, den man per Definition nicht widerlegen kann.
Meine Haltung dazu
Der folgende Absatz ist explizit meine persönliche Meinung – kein Lösungsvorschlag, keine Handlungsempfehlung für Redaktionen oder Plattformen, sondern eine Haltung, die ich für mich selbst im Umgang mit Texten entwickelt habe. Ausdrücklich nur für Texte, nicht für Bild, Ton oder Video – das sind andere Baustellen mit anderen Risiken, etwa bei Deepfakes, wo Herkunft sehr wohl eine Rolle spielt.
Es kommt einfach weiterhin auf den Text an. Ganz einfach: Ist der Text für mich relevant, erfahre ich etwas Wertvolles, habe ich Spaß am Lesen, kann ich etwas lernen? Dann ist es nebensächlich, ob der Text rein menschlich geschrieben ist oder ob eine KI bei der Recherche geholfen, kritisch gegengelesen oder gar den ganzen Text geschrieben hat.
Das andere entscheidende Kriterium: Ein Mensch zeichnet verantwortlich für den Text. Er hat entschieden, diesen Text zu veröffentlichen, weil er seinen Ansprüchen genügt. Dann ist es, wie gesagt, wenig relevant, ob und wie KI mitgearbeitet hat. Anstandshalber erwarte ich aber, dass immer alle Beteiligten an einem Text genannt werden – auch eine KI.
Bemerkenswerterweise trifft sich diese private Haltung mit einer Stelle im EU-Gesetzestext, die in der öffentlichen Debatte kaum jemand zitiert: Auch der Gesetzgeber befreit redaktionell verantwortete Texte von der Kennzeichnungspflicht, sobald ein Mensch dafür geradesteht. Das macht meine Meinung nicht zur objektiven Wahrheit – sie bleibt Meinung. Aber es ist eine hübsche Koinzidenz, dass ausgerechnet ein EU-Gesetzestext und meine Substack-Kolumne an derselben Stelle landen.
Und jetzt für alle, die sich immer noch fragen – hier die Offenlegung:
Dieser Beitrag entstand mit Hilfe von Anthropic Claude.
Der Promptologe10.08.2026
Meine gesammelten Erkenntnisse aus der wunderbaren Welt der KI-Entwicklung
Quellen
Marktüberblick / Studienlage
The blind spot in AI detection (Epoch-AI-Studie, Jaeho Lee) – digital-publishing-report.com, 28.7.2026
Die Text-DNA – digital-publishing-technologien.de, 12.5.2026
Top 5 Deepfake Detection Tools of 2026 – Deepak Gupta
Deepfake Detection Companies: 12 Top Vendors (2026) – DeepfakeDetector.ai
Rechtsrahmen
Artikel 50: Transparenzverpflichtungen für Anbieter und Betreiber bestimmter KI-Systeme – artificialintelligenceact.eu (Future of Life Institute), Originaltext
Ethik / Fallbeispiele
A Palo Alto high schooler was accused of AI cheating – SF Standard, 11.5.2026
AI Cheating Lawsuits Tracker (2026) – GradPilot
Ich schreibe Bücher – KI hilft dabei – na und? (Fall Shy Girl/Mia Ballard/Hachette) – digital-publishing-technologien.de, 21.4.2026
Substack / Pangram
Chris Best: Against Claudefishing
Micky: Das Geschäft mit KI-Scores – The Serpent Under’t, 28.7.2026
Substack adds AI detection to fight ‘Claudefishing’ – The Next Web
LinkedIn Wants Users to Lean Less on AI. Maybe a Lot Less. – Wall Street Journal, 7.8.2026
LinkedIn dreht sich um 180 Grad und ist jetzt gegen KI – all-ai.de
LinkedIn versucht, KI-generierte Inhalte zu reduzieren – Dataconomy DE
LinkedIn legt vor – Schlechte KI-Inhalte auf Knopfdruck melden – Gamestar