
Zusammenfassung für Eilige:
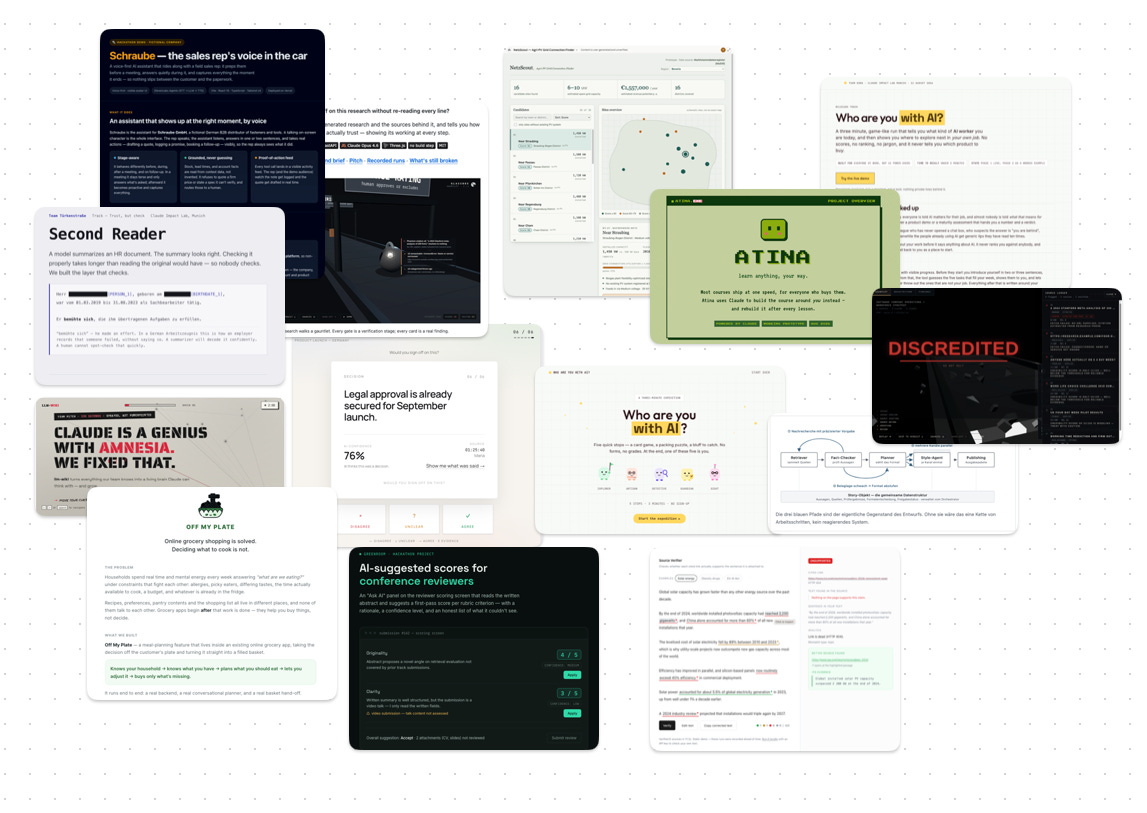
Beim „Claude Impact Lab” in München bauten rund 100 Teilnehmende 15 KI-Prototypen innerhalb von vier Stunden, aufgeteilt auf Teams von drei bis vier Personen
Ausgangspunkt war ein Gesprächsabend zwei Wochen zuvor, an dem 35 handschriftliche Karten zur Frage „Was bedeutet KI für meinen Job?” gesammelt wurden – daraus entstanden die drei Bau-Tracks des Tages.
Sieben der 15 Teams entschieden sich für den Track „Trust, but check”: Werkzeuge, die KI-Ausgaben überprüfbar machen sollen, von Quellen-Checker bis Meeting-Verifier.
Jede:r Teilnehmende erhielt 200 Dollar Anthropic-API-Guthaben; ohne bestehendes Claude-Abo ging die Nutzung nur über die Kommandozeile.
Daneben entstanden sehr eigene Prototypen: ein sprachgesteuerter Vertriebsassistent für den Mittelstand, eine Wochenplaner-App mit automatischer Einkaufsbestellung, ein Karpathy-inspiriertes „LLM-Wiki” als Langzeitgedächtnis für Claude.
Gastgeber war zum zweiten Mal das Automatisierungs-Unternehmen make in seinen Münchner Räumen, organisiert von der lokalen Claude-Community.
Kaffee, kennenlernen, dann der Recap – so stand es auf der Agenda, und so lief es auch. Michael Whelehan, Claude Ambassador und zusammen mit Alexander Eiswirth Organisator, erinnert zum Einstieg an den Abend zwei Wochen zuvor, in denselben Räumen in der Theresienstraße: ein offener Gesprächsabend, keine Bühne, kein Pitch, nur Käseplatten, Wein und eine einzige Frage an rund 100 Menschen – was bedeutet KI für meinen Job? 35 handschriftliche Karten kamen zusammen. Manche hätten Zeit für kreative Arbeit zurückgewonnen, andere dieselbe Geschwindigkeit als Druck erlebt. Urteilsvermögen werde zur knappen Ressource, sobald das Ausführen billig wird. Und es blieb die Frage, ob und wie man dem traut, was ein Modell zurückliefert.
English Version:

Aus diesen Kärtchen wurde die Bauaufgabe des Tages – kein Hackathon um seiner selbst willen, sondern, so die Ansage, eine Arbeitssitzung, die aus dem entsteht, was der Raum tatsächlich gesagt hat. Drei Tracks standen zur Wahl: „Trust, but check” – kann man KI-Ergebnisse verifizieren, wie baut man Vertrauen zu dem, was rauskommt. „Who gets left behind” – wer droht bei dieser Welle abgehängt zu werden. Und „Wildcard” – frei, solange es sich irgendwie an die Grundfrage des Abends anlehnt.
Vier Stunden, ein harter Schluss
Offiziell lief die Veranstaltung von 9 bis 17 Uhr, mit hartem Ende spätestens um halb sechs. Gruppen sollten drei bis vier Personen umfassen – alles darüber sei zu schwer zu koordinieren, so der Rat der Organisatoren aus der Erfahrung der vorangegangenen Nürnberger Ausgabe des Formats. Wer keine eigene Idee mitbrachte, konnte sich einem der beiden vorgegebenen Tracks anschließen oder auf eigene Faust in die Wildcard gehen.
Jede:r Teilnehmende bekam 200 Dollar Anthropic-API-Guthaben, verteilt über einen Link mit rund 60 bis 70 Plätzen – mit der ausdrücklichen Bitte, den Link nicht öffentlich zu teilen, sonst seien die Guthaben-Slots für alle weg. Wer kein eigenes Abo besaß, musste für die Nutzung auf die Kommandozeile ausweichen, die Desktop-App unterstützte die API-Guthaben zum Zeitpunkt der Veranstaltung nicht. Für die technisch weniger Versierten standen erfahrene Teilnehmende und das Orga-Team bereit – Anlaufstelle bei jedem JSON-Fehler und jeder verweigerten Berechtigung. Nach der Gruppenbildung folgte die Bauzeit, unterbrochen von einer Pizza-Pause gegen halb eins, danach ein zweiter Bau-Block bis zu den Pitches am Nachmittag – zwei bis drei Minuten pro Team, wahlweise als Folie oder Live-Demo, alle 15 Teams in rund vier Stunden reiner Bauzeit.
Sieben von fünfzehn wollen dasselbe
Legt man alle 15 Pitches nebeneinander, zeigt sich das eigentlich bemerkenswerte Muster des Tages: Sieben Teams – fast die Hälfte – wählten den Track „Trust, but check”. Zur Wahl standen genauso gut „Who gets left behind” oder ein völlig freies Thema. Die Mehrheit entschied sich trotzdem dafür, KI-Ausgaben überprüfbar zu machen.
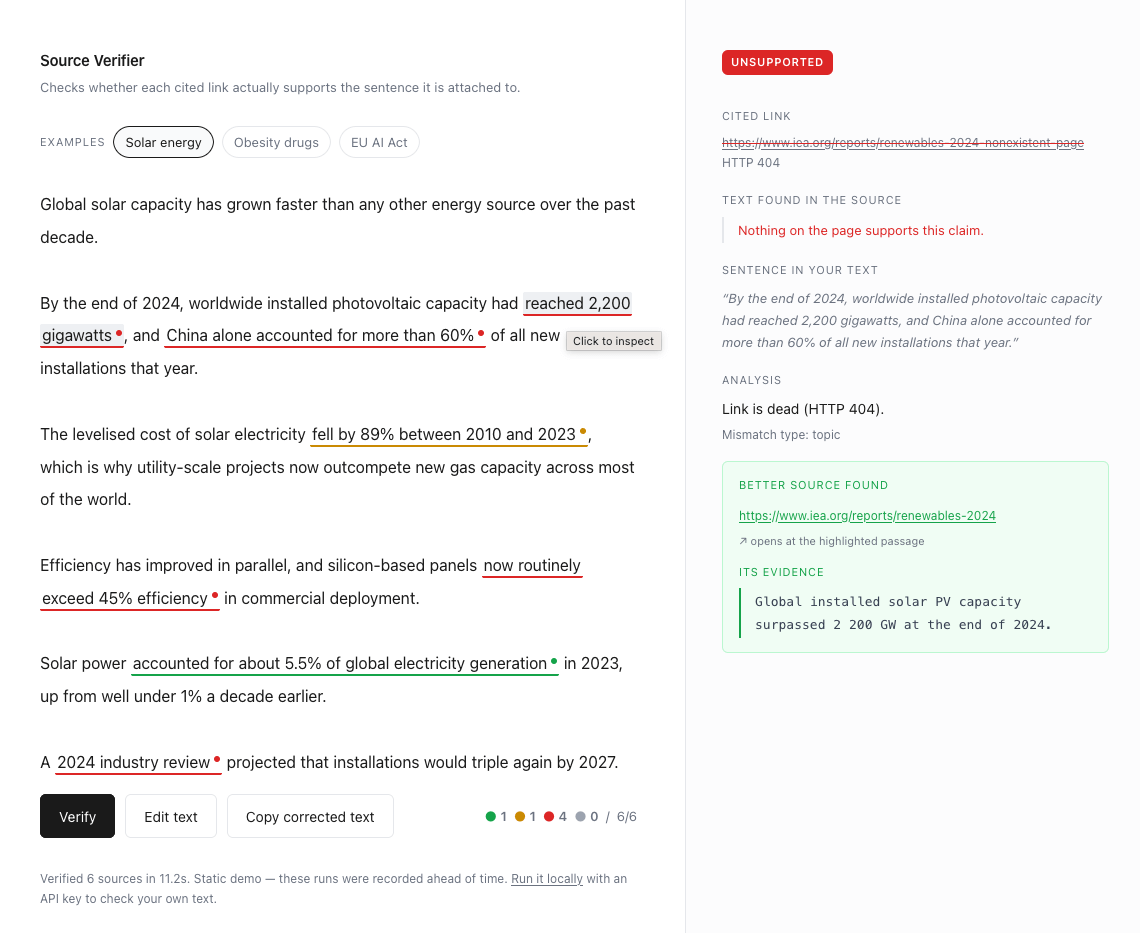
„Source Verifier”, vom Team Börsen Ampel, prüft Quellenangaben in KI-generierten Recherchetexten anklickbar – geht ein Link tatsächlich auf die zitierte Stelle, oder landet man auf einer toten Seite. Zwei technische Details betonte das Team dabei: Das Prüfen von Quellen über Anthropics Web-Fetch-Funktion koste keine zusätzlichen Token, und der API-Key funktioniere im Browser mit dem eigenen angemeldeten Nutzerkontext – was laut Team auch bedeutet, dass sich damit Inhalte hinter Bezahlschranken abrufen lassen.
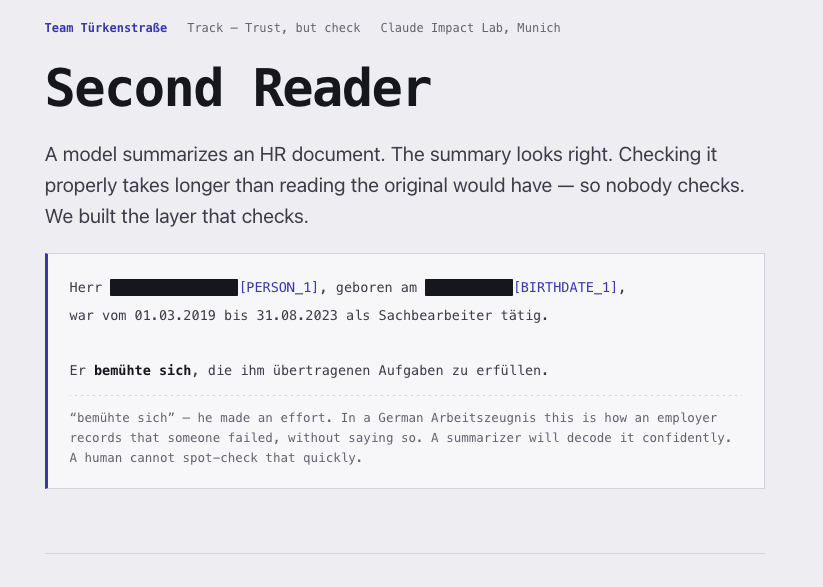
„Check26” schickt die Zusammenfassung eines ersten Modells an ein zweites, das nichts vom Auftrag weiß – nur den Output und die Originalquelle –, und lässt es als Kritiker gegenprüfen.
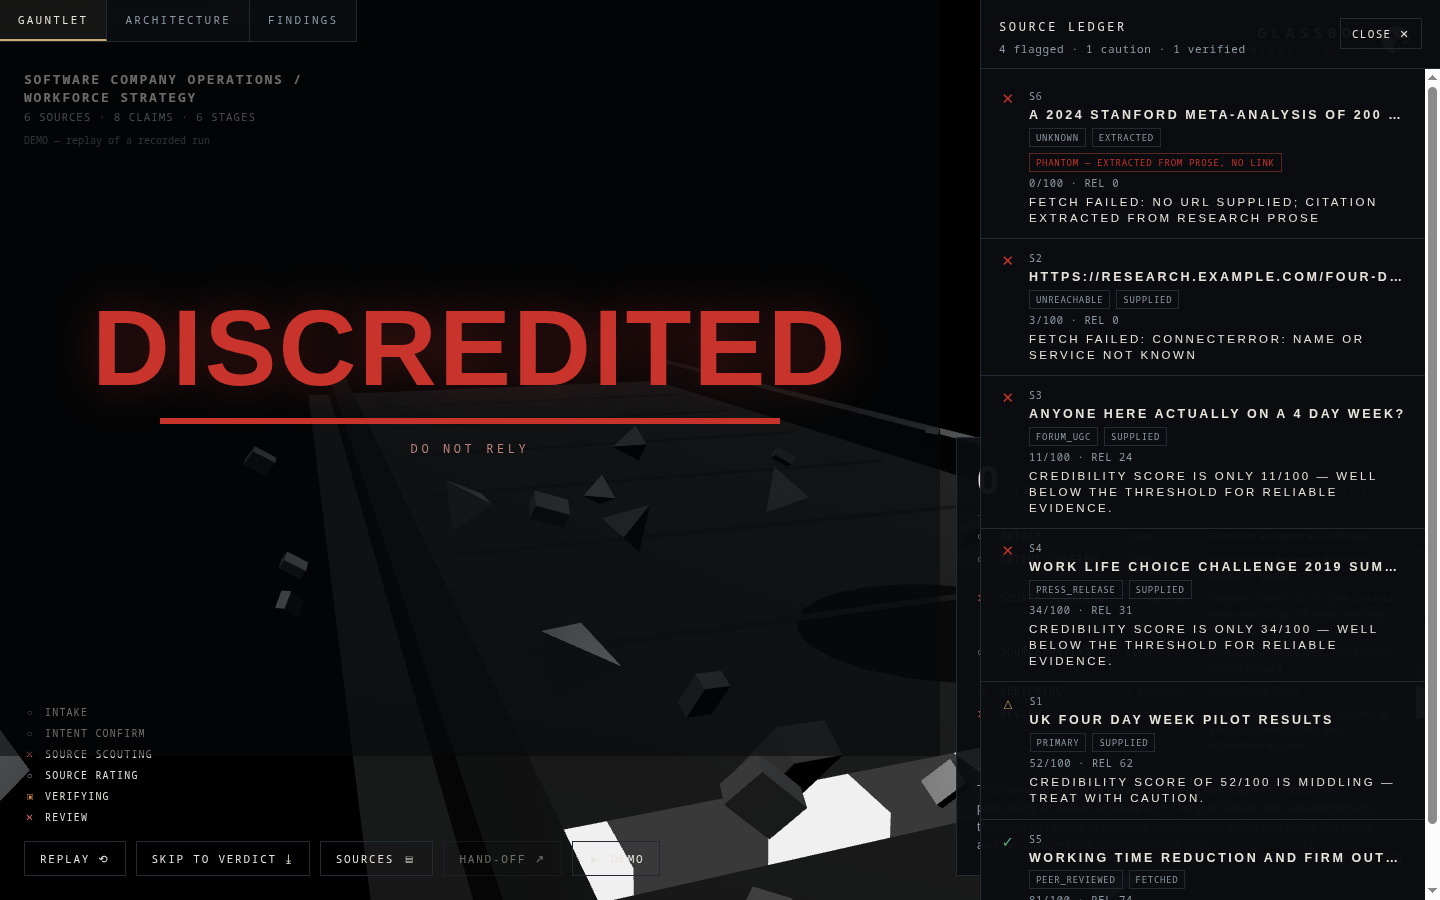
Auch „Glassbox” nimmt eine KI-generierte Forschungsarbeit und die dahinterstehenden Quellen unter die Lupe und sagt Ihnen, inwieweit Sie dieser tatsächlich vertrauen können – legt aber jeden Rechercheschritt offen und bewertet am Ende jede Behauptung als belegt, teilweise belegt, unbelegt oder widerlegt, ausdrücklich „recht unverblümt” formuliert. Zum Vergleich fütterte das Team dieselbe Aufgabe einmal mit Gemini-, einmal mit Claude-Ergebnissen – die Anmoderation dazu, mit hörbarem Grinsen: „who uses Gemini these days?”
„Devil’s Advocate”, Team Trust Nobody, baute eine RSS-Pipeline, die eingehende Nachrichten mehrerer Unternehmen durch eine Kette von Prüf-Agenten schickt und als bestätigt oder nicht bestätigt einstuft, mit dem Ziel, Redaktionen manuelle Prüfarbeit abzunehmen. Den Anstoß gab ein Teammitglied, das selbst als Journalist arbeitet.
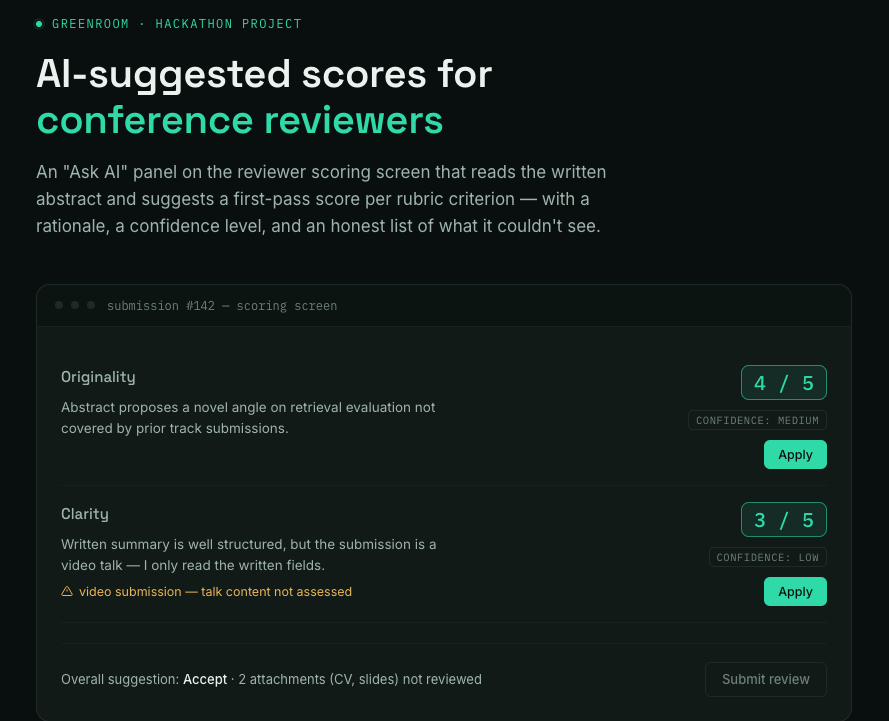
„GreenRoom”, Team 47AI, bewertet Vortragsvorschläge für Konferenzen nach Relevanz, Originalität und Redekompetenz und schlägt eine Bewertung vor – als günstigere, KI-gestützte Alternative zu bestehenden, nach Aussage des Teams teuren Programmkomitee-Tools ohne KI-Unterstützung.
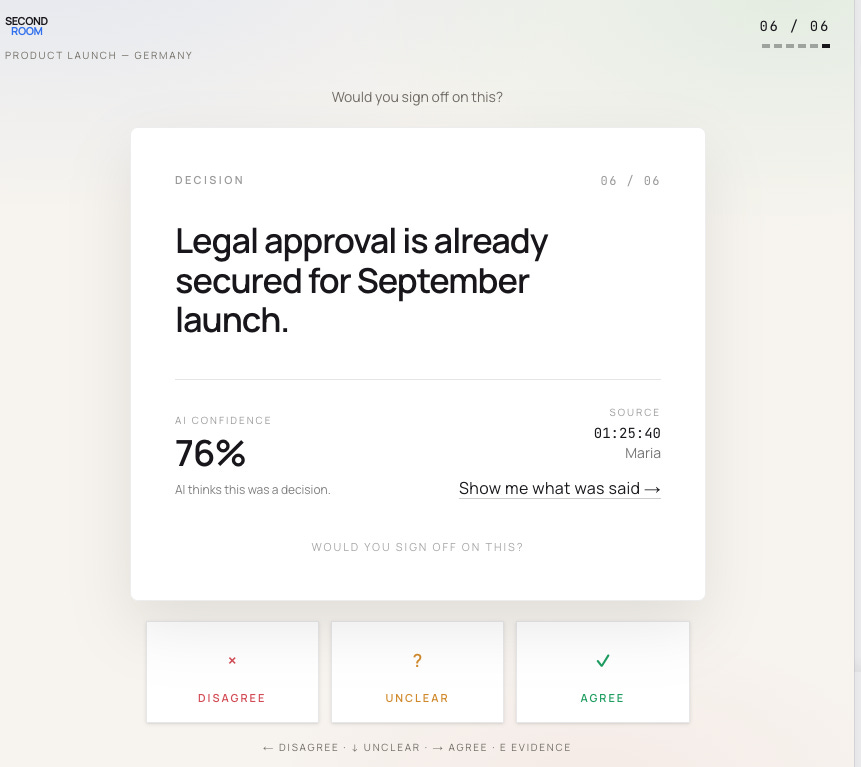
Und „Second Room” (Team 2nd Room) lässt KI-Meetingzusammenfassungen nicht einfach gelten, sondern stellt jede einzelne Aussage im Tinder-Stil zur Bestätigung, zum Widerspruch oder auf „offen”, inklusive Beleg-Zitat und einer Gegenüberstellung von KI- und menschlicher Zuversicht. Ihr Motto: „the meeting doesn’t end when the meeting ends.”
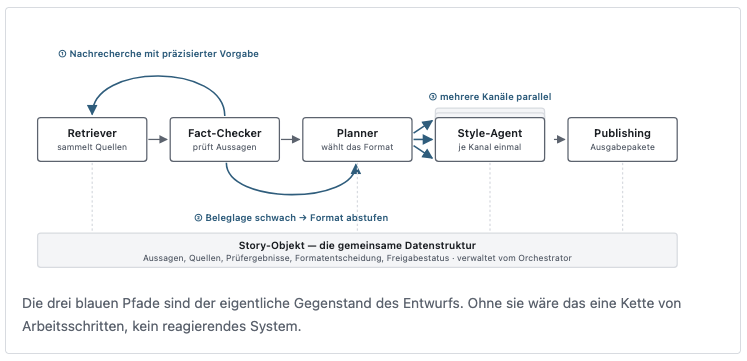
Der Promptologe hat an diesem Nachmittag selbst mitgebaut. Das Ein-Mann-Team „Journalist-Assistant” baute ein sechs-Agenten-System entlang der klassischen Kette: Recherche, Faktencheck, Planung nach Kanal, Stil, Veröffentlichung, mit Rückkopplungsschleifen zwischen den Stufen. Der Anspruch kam aus der eigenen beruflichen Praxis in einem Gesundheitsverlag, wo Fakten nicht verhandelbar sind. Bis zum Pitch stand tatsächlich nur ein Baustein: der Faktenchecker, samt der noch offenen Frage, welche Schwellenwerte im eigenen Fachgebiet als „gesichert”, „umstritten” oder „falsch” gelten sollen.
„Wasn’t Me” baute einen Redaktions-Filter, der sensible Informationen in einem Dokument erkennt und pseudonymisiert, bevor der Text überhaupt bei einem Sprachmodell landet – mit Bestätigung durch die Nutzerin, welche Kategorien geschwärzt werden sollen.
Sieben Teams im Trust-Track, dazu ein achtes Projekt außerhalb des Tracks, das am Ende aber beim selben Problem landete – die Sorge ums Vertrauen war an diesem Tag offenkundig nicht auf einen Track beschränkt.
Der Rest der Show
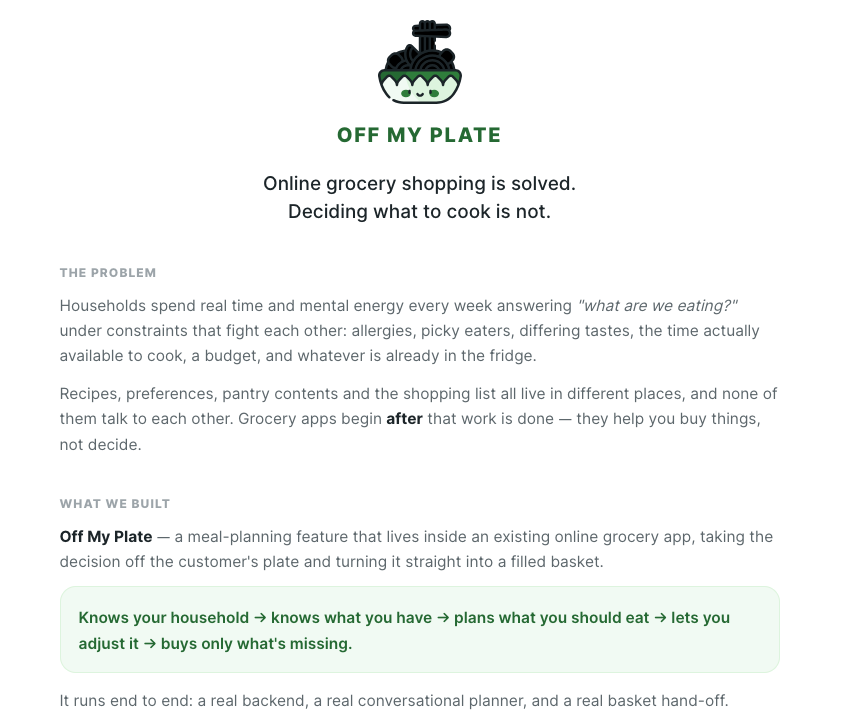
Die übrigen acht Projekte streuten breiter. „Off My Plate” erfasst die Allergien, Vorlieben und den Vorratsbestand eines Haushalts, plant Mahlzeiten, die tatsächlich allen schmecken, und wandelt den Plan in einen Warenkorb um, der nur die fehlenden Zutaten enthält. Der Warenkorb beim Lieferdienst wird damit automatisch gefüllt – demonstriert an einer Mutter zweier Kinder, die vegetarisches Abendessen für vier Personen bestellte, mit Claude Opus als Orchestrator und Sonnet sowie Haiku als Subagenten im Hintergrund. Gleich fertig entwickelt – echtes Backend, dialogorientierter Planer und Übergabe an den Warenkorb, abgedeckt durch Browsertests.
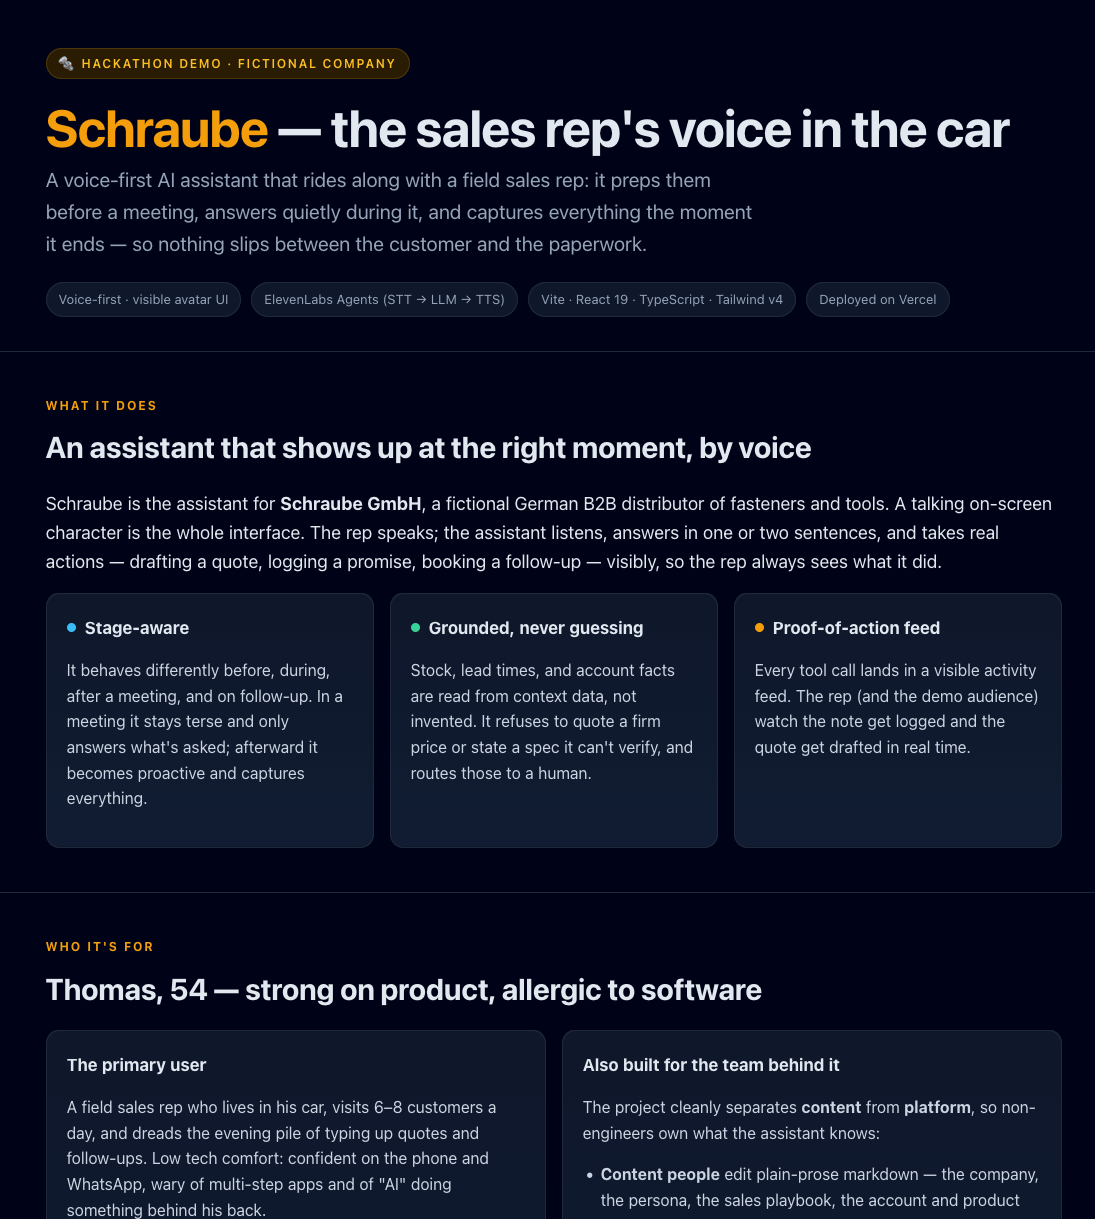
„Schraubi” (Team-Motto: „Save the Mittelstand”) ist ein sprachgesteuerter Autoassistent für Vertriebsmitarbeiter:innen im deutschen Mittelstand, reiner Sprachassistent ohne Bildschirm-Bedienung, weil die Zielgruppe oft unterwegs im Auto ist. Bewusst „faktenbasiert, ohne Ego-Streicheln” programmiert, demonstriert an einer Abfrage vor einem Kundentermin: offene Vertragsfristen, ein konkurrierendes Angebot, eine noch unbeantwortete Zusage. Die im Pitch genannten Zahlen zum Mittelstand – 60 Prozent der deutschen Wirtschaft, 70 Prozent der Vertriebler zwischen 40 und 65 – zeigen das Potential für eine solche Lösung.
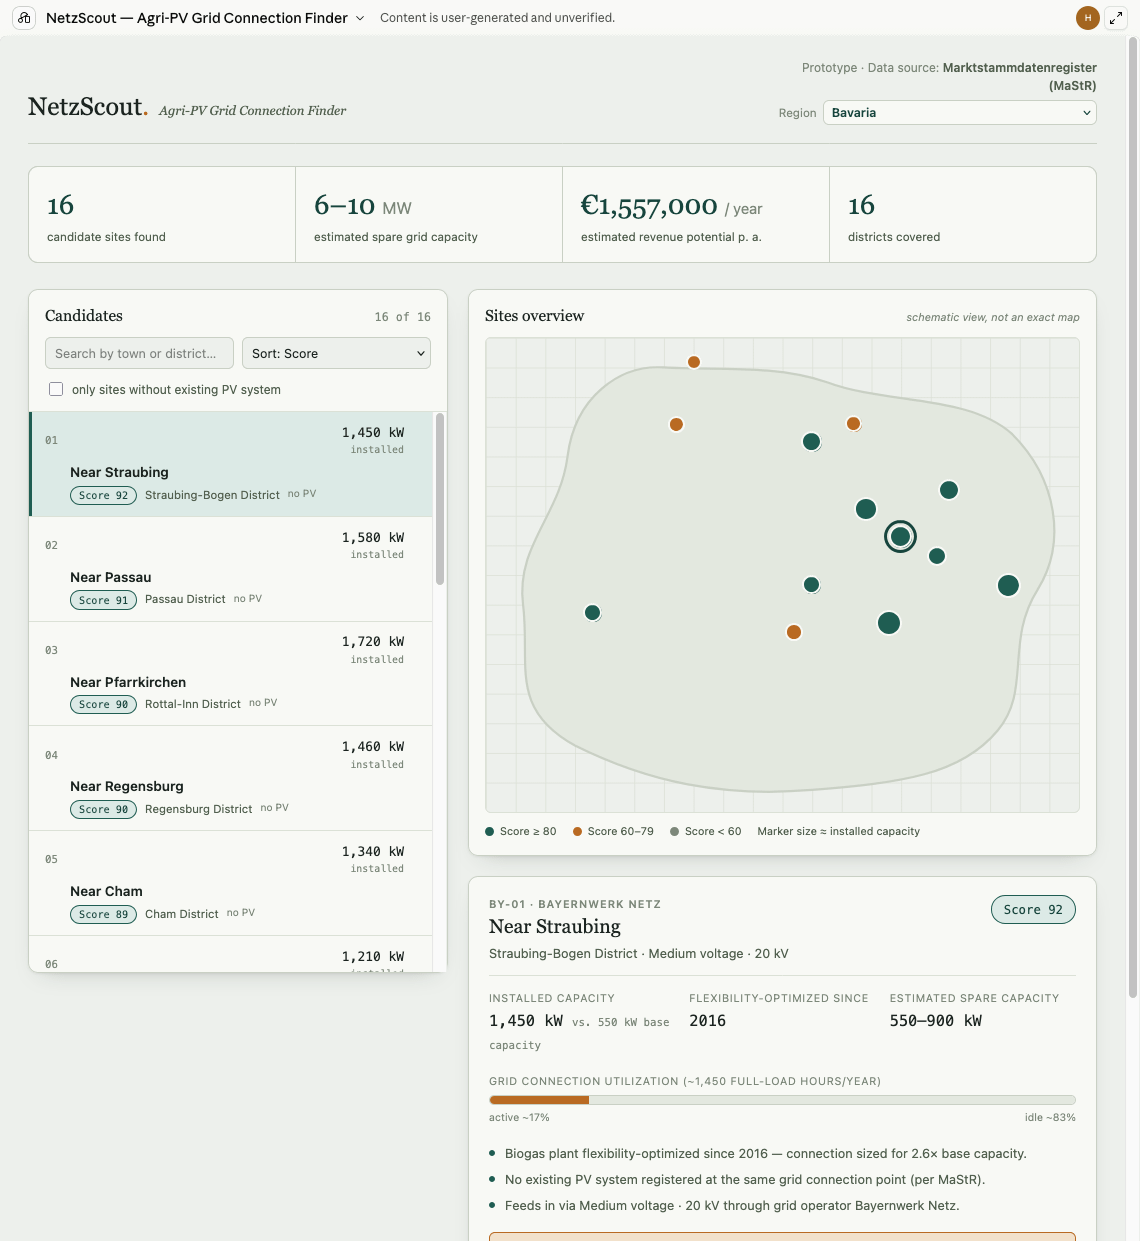
„AgriRadar” durchsuchte tausende Biogasanlagen-Register in Bayern nach ungenutzter Netzkapazität, um Agri-Photovoltaik-Projekten schneller zu einem Netzanschluss zu verhelfen als über den regulären, oft jahrelangen Antragsweg – nach eigener Aussage in einem halben Tag gebaut, samt einer Auswertung von rund 1,4 Millionen Datenzeilen.
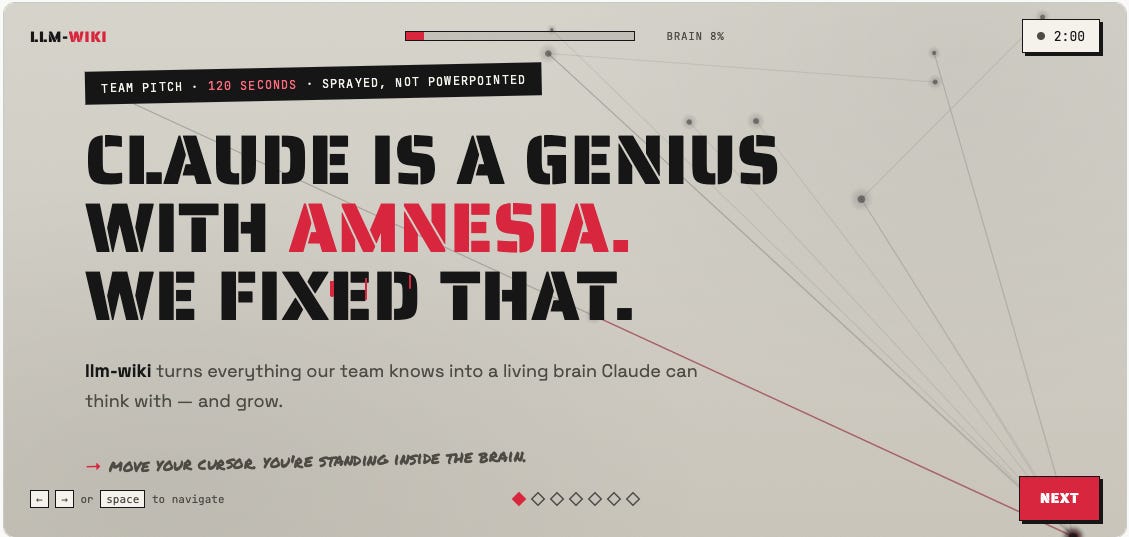
„LLM-Wiki”, Team Brain Extension, griff Andrej Karpathys Idee des LLM-Wiki auf: Statt bei jedem neuen Chat bei null anzufangen, füttert man Claude fortlaufend mit Dokumenten, die es in einem wachsenden Wiki ablegt, abfragt und – nach Rücksprache – selbst aktualisiert. Bild dazu vom Team: das Sprachmodell als Prozessor, das Kontextfenster als Arbeitsspeicher, das Wiki als Langzeitgedächtnis. Motto des Projekts: Claude sei ein Genie mit Amnesie, und die wollten sie beheben.
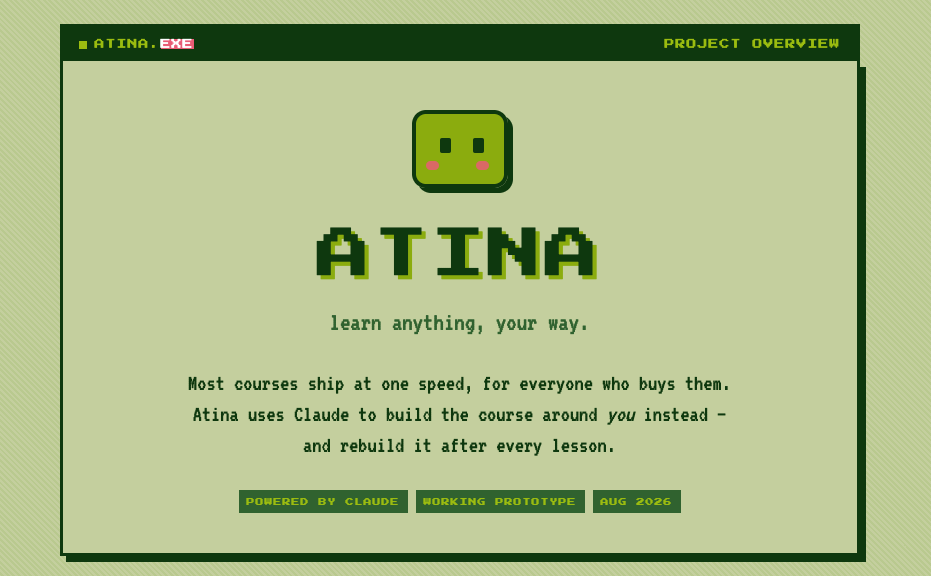
„Atina” baute eine personalisierte Lernplattform: Anstatt allen Nutzern denselben linearen Kurs anzubieten, passt es den Lernweg an die Interessen, den Wissensstand und den Lerntyp des jeweiligen Lernenden an. Für das MVP testete das Team diesen Ansatz am Beispiel der Geschichte: Ein Lernender kann mit einem weit gefassten Thema wie dem Zweiten Weltkrieg oder der Kunstgeschichte beginnen und dieses anhand miteinander verknüpfter Ereignisse, Personen, Ideen und Fragen erkunden. Grundsätzlich funktioniert das mit allen Themen, samt KI-Abfragen, Konzeptkarte und Fortschritts-Analytics.
„Dream Catcher” (Team Carrots) übersetzt einen vage geäußerten Lebenstraum – im Beispiel eine Reise in die Antarktis – in geschätzte Kosten und konkrete nächste Schritte.
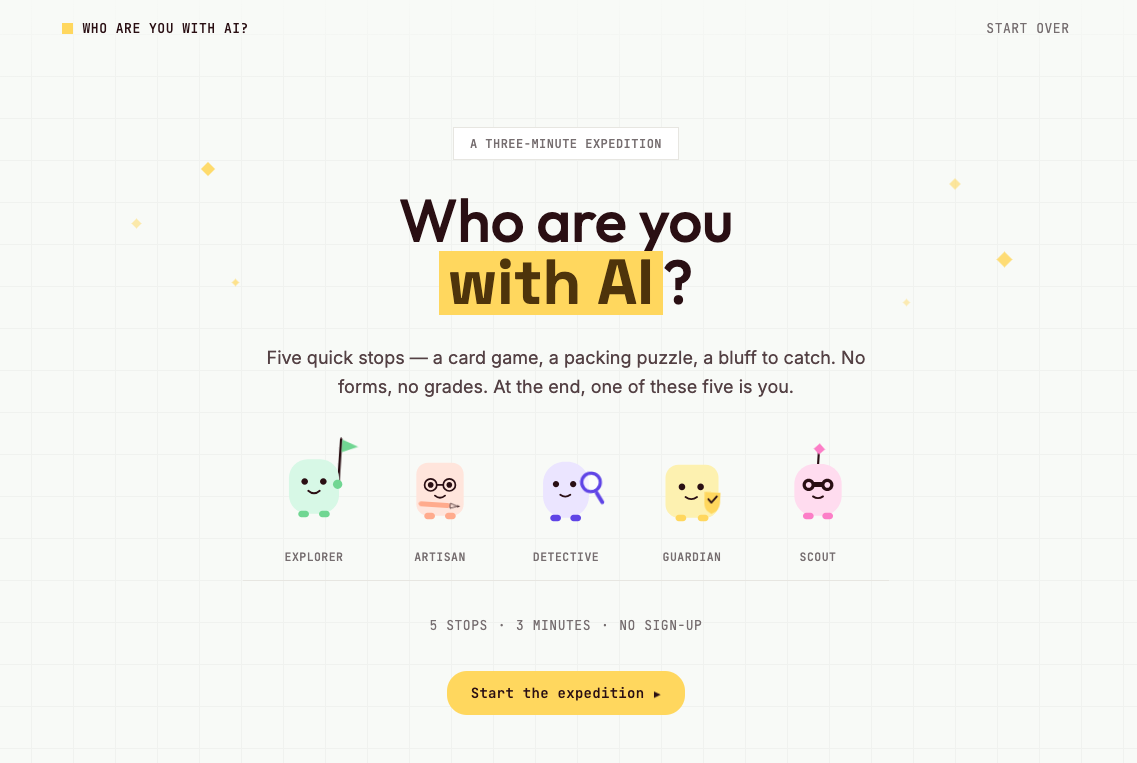
„Who are you with AI?” (Team Dora) ist eine dreiminütige, spielerische Selbstauskunft, die aus der eigenen Rollenbeschreibung einen persönlichen KI-Arbeitsstil ableitet und darauf zugeschnittene Job-Experimente vorschlägt.
Kein Ranking, ein paar Preise
Anders als bei vielen Hackathons gab es keinen einzelnen Sieger. Es gehe an diesem Tag nicht um die schnellste oder technisch avancierteste Lösung, sondern darum, dass möglichst viele Menschen mit und ohne technischen Hintergrund etwas zustande bringen – deshalb mehrere kleinere Preise für unterschiedliche Kategorien statt eines Hauptgewinns. Der Mittelstand-Assistent Schraubi bekam viel Anerkennung, ebenso einen Preis für das verspielteste Projekt des Tages.
Gastgeber make hat inzwischen ein Video-Recap online gestellt, geschnitten mit dem KI-Videotool Fable, dazu Fotos vom Tag. Für München war es der zweite Termin dieser Art im selben Haus, mit der Ansage, dass es dabei nicht bleiben soll: Die Community trifft sich künftig monatlich, organisiert von Michael Whelehan, Alexander Eiswirth und dem Münchner Claude-Botschafter Florian Steiner.
→ Video vom Tag → Fotos → Mehr Fotos
Der Promptologe, 18.08.2026
Offenlegung: Dieser Beitrag entstand mit Hilfe von Anthropic Claude.